Javascript строки
Содержание:
- Поиск подстроки в строке средствами sql
- SQL функции для объединения строк
- Улучшена поддержка юникода
- Соединение строк в Java
- SQL References
- RemarksRemarks
- str.replace(str|regexp, str|func)
- Разделение строк на подстроки в C#
- JavaScript
- Обрабатываем строку в Python
- Разделение на подстроки в Python
- String HTML Wrapper Methods
Поиск подстроки в строке средствами sql
Для вычисления позиции подстроки в строке в языке sql существует несколько функций. Первая, которую мы рассмотрим, функция POSITION:
integer POSITION(substr string IN str string)
Возвращает номер позиции первого вхождения подстроки substr в строке str и возвращает 0 если подстрока не найдена. Функция POSITION может работать с многобайтовыми символами.
Пример:
SELECT POSITION (‘cd’ IN ‘abcdcde’);
Результат: 3
SELECT POSITION (‘xy’ IN ‘abcdcde’);
Результат: 0
Следующая функция LOCATE позволяет начинать поиск подстроки с определенной позиции:
integer LOCATE(substr string, str string, pos integer)
Возвращает позицию первого вхождения подстроки substr в строке str, начиная с позиции pos. Если параметр pos не задан, то поиск осуществляется с начала строки. Если подстрока substr не найдена, то возвращает 0. Поддерживает многобайтовые символы.
Пример:
SELECT LOCATE (‘cd’, ‘abcdcdde’, 5);
Результат: 5
SELECT LOCATE (‘cd’, ‘abcdcdde’);
Результат: 3
Аналогом функций POSITION и LOCATE является функция INSTR:
integer INSTR(str string, substr string)
Также как и функции выше возвращает позицию первого вхождения подстроки substr в строке str. Единственное отличие от функций POSITION и LOCATE то, что аргументы поменяны местами.
Далее рассмотрим функции, которые помогают получить подстроку.
Первыми рассмотрим сразу две функции LEFT и RIGHT, которые похожи по своему действию:
string LEFT(str string, len integer)string RIGHT(str string, len integer)
Функция LEFT возвращает len первых символов из строки str, а функция RIGHT столько же последних. Поддерживают многобайтовые символы.
Пример:
SELECT LEFT (‘Москва’, 3);
Результат: Мос
SELECT RIGHT (‘Москва’, 3);
Результат: ква
Далее рассмотрим одинаковые по итоговому результату функции SUBSTRING и MID:
string SUBSTRING(str string, pos integer, len integer)string MID(str string, pos integer, len integer)
Функции позволяют получить подстроку строки str длиною len символов с позиции pos. В случае если параметр len не задан, то возвращается вся подстрока начиная с позиции pos.
Пример:
SELECT SUBSTRING (‘г. Москва — столица России’, 4, 6);
Результат: Москва
SELECT SUBSTRING (‘г. Москва — столица России’, 4);
Результат: Москва — столица России
Примеры с функцией MID не привожу, потому что результаты будут аналогичные.
Интересная функция SUBSTRING_INDEX:
string SUBSTRING_INDEX(str string, delim string, count integer)
Функция возвращает подстроку строки str, полученную путем удаления символов, идущих после разделителя delim, находящимся в позиции count. Параметр count может быть как положительным, так отрицательным. Если count положительный, то отсчет позиции разделителя будет вестись слева и удаляться будут символы находящиеся справа от разделителя. Если count отрицательный, то отсчет позиции разделителя ведется справа и удаляются символы находящиеся слева от разделителя. Возможно, описание получилось слишком запутанным, но на примерах станет понятней.
Пример:
SELECT SUBSTRING_INDEX (‘www.mysql.ru’, ‘.’, 1);
Результат: www
В данном примере функция находит, первое вхождения символа точки в строке «www.mysql.ru» и удаляет все символы, идущие после нее, включая сам разделитель.
SELECT SUBSTRING_INDEX (‘www.mysql.ru’, ‘.’, 2);
Результат: www.mysql
Здесь функция ищет второе вхождение точки, удаляет все символы справа от нее и возвращает получившуюся подстроку. И еще один пример с отрицательным значением параметра count:
SELECT SUBSTRING_INDEX (‘www.mysql.ru’, ‘.’, -2);
Результат: mysql.ru
В этом примере функция SUBSTRING_INDEX ищет вторую точку, отсчитывая позицию справа, удаляет символы слева от нее и выдает полученную подстроку.
SQL функции для объединения строк
Одна из самых популярных категорий функций. Ведь частенько бывает нужно объединить значения нескольких полей таблиц базы данных сайта. В языке SQL есть сразу несколько функций для конкатенации строк.
Функция CONCAT:
string CONCAT(str1 string, str2 string,…)
Функция возвращает строку, созданную путем объединения аргументов. Можно указывать более двух аргументов. Если один из аргументов является NULL, то и возвращаемый результат будет NULL. Числовые значения преобразуются в строку.
Пример:
SELECT CONCAT (‘Hello’, ‘ ‘, ‘world’, ‘!’);
Результат: ‘Hello world!’
SELECT CONCAT (‘Hello’, NULL, ‘world’, ‘!’);
Результат: NULL
SELECT CONCAT (‘Число пи’, ‘=’, 3.14);
Результат: ‘Число пи=3.14’
Как видно из примеров, строки объединяются без разделителей. Для того чтобы разделить слова в первом примере в качестве аргумента приходится использовать пробел. Если бы слов было больше, то каждый раз вставлять пробелы было бы не очень удобно.
Для таких случаев существует функция CONCAT_WS:
string CONCAT_WS(separator string, str1 string, str2 string,…)
Функция объединяет строки как и функция CONCAT, но вставляет между аргументами разделитель separator. В случае если аргумент separator является NULL, то и результат будет NULL. Аргументы строки равные NULL пропускаются.
Пример:
SELECT CONCAT_WS (‘ ‘, ‘Иванов’, ‘Иван’, ‘Иванович’);
Результат: ‘Иванов Иван Иванович’
SELECT CONCAT_WS (NULL, ‘Иванов’, ‘Иван’, ‘Иванович’);
Результат: NULL
SELECT CONCAT_WS (‘ ‘, ‘Иванов’, NULL, ‘Иван’, ‘Иванович’);
Результат: »Иванов Иван Иванович’
В случае объединения большого количества строк, которые необходимо отделять разделителем, функция CONCAT_WS гораздо удобнее функции CONCAT.
Иногда бывает необходимо удлинить строку до определенного количества символов за счет повторения какого-либо символа. Это тоже своего рода объединение строк. Для этого можно использовать функции LPAD и RPAD. Функции имеют следующий синтаксис:
string LPAD(str string, len integer, padstr string)string RPAD(str string, len integer, padstr string)
Функция LPAD возвращает строку str дополненную слева строкой padstr до длины len. Функция RPAD выполняет тоже самое, только удлинение происходит с правой стороны.
Пример:
SELECT LPAD (‘test’, 10, ‘.’);
Результат: ……test
SELECT RPAD (‘test’, 10, ‘.’);
Результат: test……
В данных функциях необходимо обратить внимание на параметр len, который ограничивает количество выводимых символов. Поэтому если длина строки str будет больше чем параметр len, то строка будет обрезана:. SELECT LPAD (‘test’, 3, ‘.’);
Результат: tes
SELECT LPAD (‘test’, 3, ‘.’);
Результат: tes
Улучшена поддержка юникода
Внутренняя кодировка строк в JavaScript – это UTF-16, то есть под каждый символ отводится ровно два байта.
Но под всевозможные символы всех языков мира 2 байт не хватает. Поэтому бывает так, что одному символу языка соответствует два юникодных символа (итого 4 байта). Такое сочетание называют «суррогатной парой».
Самый частый пример суррогатной пары, который можно встретить в литературе – это китайские иероглифы.
Заметим, однако, что не всякий китайский иероглиф – суррогатная пара. Существенная часть «основного» юникод-диапазона как раз отдана под китайский язык, поэтому некоторые иероглифы – которые в неё «влезли» – представляются одним юникод-символом, а те, которые не поместились (реже используемые) – двумя.
Например:
В тексте выше для первого иероглифа есть отдельный юникод-символ, и поэтому длина строки , а для второго используется суррогатная пара. Соответственно, длина – .
Китайскими иероглифами суррогатные пары, естественно, не ограничиваются.
Ими представлены редкие математические символы, а также некоторые символы для эмоций, к примеру:
В современный JavaScript добавлены методы String.fromCodePoint и str.codePointAt – аналоги и , корректно работающие с суррогатными парами.
Например, считает суррогатную пару двумя разными символами и возвращает код каждой:
…В то время как возвращает его Unicode-код суррогатной пары правильно:
Метод корректно создаёт строку из «длинного кода», в отличие от старого .
Например:
Более старый метод в последней строке дал неверный результат, так как он берёт только первые два байта от числа и создаёт символ из них, а остальные отбрасывает.
Есть и ещё синтаксическое улучшение для больших Unicode-кодов.
В JavaScript-строках давно можно вставлять символы по Unicode-коду, вот так:
Синтаксис: , где – четырёхзначный шестнадцатиричный код, причём он должен быть ровно четырёхзначным.
«Лишние» цифры уже не войдут в код, например:
Чтобы вводить более длинные коды символов, добавили запись , где – максимально восьмизначный (но можно и меньше цифр) код.
Например:
Во многих языках есть символы, которые получаются как сочетание основного символа и какого-то значка над ним или под ним.
Например, на основе обычного символа существуют символы: . Самые часто встречающиеся подобные сочетания имеют отдельный юникодный код. Но отнюдь не все.
Для генерации произвольных сочетаний используются несколько юникодных символов: основа и один или несколько значков.
Например, если после символа идёт символ «точка сверху» (код ), то показано это будет как «S с точкой сверху» .
Если нужен ещё значок над той же буквой (или под ней) – без проблем. Просто добавляем соответствующий символ.
К примеру, если добавить символ «точка снизу» (код ), то будет «S с двумя точками сверху и снизу» .
Пример этого символа в JavaScript-строке:
Такая возможность добавить произвольной букве нужные значки, с одной стороны, необходима, а с другой стороны – возникает проблемка: можно представить одинаковый с точки зрения визуального отображения и интерпретации символ – разными сочетаниями Unicode-кодов.
Вот пример:
В первой строке после основы идёт сначала значок «верхняя точка», а потом – нижняя, во второй – наоборот. По кодам строки не равны друг другу. Но символ задают один и тот же.
С целью разрешить эту ситуацию, существует юникодная нормализация, при которой строки приводятся к единому, «нормальному», виду.
В современном JavaScript это делает метод str.normalize().
Забавно, что в данной конкретной ситуации приведёт последовательность из трёх символов к одному: \u1e68 (S с двумя точками).
Это, конечно, не всегда так, просто в данном случае оказалось, что именно такой символ в юникоде уже есть. Если добавить значков, то нормализация уже даст несколько символов.
Для большинства практических задач информации, данной выше, должно быть вполне достаточно, но если хочется более подробно ознакомиться с вариантами и правилами нормализации – они описаны в приложении к стандарту юникод Unicode Normalization Forms.
Соединение строк в Java
Чтобы соединить строки в Java, подойдёт операция сложения «+»:
String str1 = "Java";
String str2 = "Hi";
String str3 = str1 + " " + str2;

System.out.println(str3); // Hi Java
Если же в предстоящей операции сложения строк будет применяться нестроковый объект, допустим, число, данный объект преобразуется к строке:
String str3 = "Год " + 2020;
По факту, когда мы складываем строки с нестроковыми объектами, вызывается метод valueOf() класса String. Этот метод преобразует к строке почти все типы данных. Чтобы преобразовать объекты разных классов, valueOf вызывает метод toString() данных классов.
Объединять строки можно и с помощью concat():
String str1 = "Java";
String str2 = "Hi";
str2 = str2.concat(str1); // HiJava
Метод принимает строку, с которой нужно объединить вызывающую строку, возвращая нам уже соединённую строку.
Также мы можем использовать метод join(), позволяющий объединять строки с учетом разделителя. Допустим, две строки выше слились в слово «HiJava», однако мы бы хотели разделить подстроки пробелом. Тут и пригодится join():
String str1 = "Java";
String str2 = "Hi";
String str3 = String.join(" ", str2, str1); // Hi Java
Метод join — статический. Первый параметр — это разделитель, который будет использоваться для разделения подстрок в общей строке. Последующие параметры осуществляют передачу через запятую произвольного набора объединяемых подстрок — в нашем случае их две, но можно и больше.
SQL References
SQL Keywords
ADD
ADD CONSTRAINT
ALTER
ALTER COLUMN
ALTER TABLE
ALL
AND
ANY
AS
ASC
BACKUP DATABASE
BETWEEN
CASE
CHECK
COLUMN
CONSTRAINT
CREATE
CREATE DATABASE
CREATE INDEX
CREATE OR REPLACE VIEW
CREATE TABLE
CREATE PROCEDURE
CREATE UNIQUE INDEX
CREATE VIEW
DATABASE
DEFAULT
DELETE
DESC
DISTINCT
DROP
DROP COLUMN
DROP CONSTRAINT
DROP DATABASE
DROP DEFAULT
DROP INDEX
DROP TABLE
DROP VIEW
EXEC
EXISTS
FOREIGN KEY
FROM
FULL OUTER JOIN
GROUP BY
HAVING
IN
INDEX
INNER JOIN
INSERT INTO
INSERT INTO SELECT
IS NULL
IS NOT NULL
JOIN
LEFT JOIN
LIKE
LIMIT
NOT
NOT NULL
OR
ORDER BY
OUTER JOIN
PRIMARY KEY
PROCEDURE
RIGHT JOIN
ROWNUM
SELECT
SELECT DISTINCT
SELECT INTO
SELECT TOP
SET
TABLE
TOP
TRUNCATE TABLE
UNION
UNION ALL
UNIQUE
UPDATE
VALUES
VIEW
WHERE
MySQL Functions
String Functions
ASCII
CHAR_LENGTH
CHARACTER_LENGTH
CONCAT
CONCAT_WS
FIELD
FIND_IN_SET
FORMAT
INSERT
INSTR
LCASE
LEFT
LENGTH
LOCATE
LOWER
LPAD
LTRIM
MID
POSITION
REPEAT
REPLACE
REVERSE
RIGHT
RPAD
RTRIM
SPACE
STRCMP
SUBSTR
SUBSTRING
SUBSTRING_INDEX
TRIM
UCASE
UPPER
Numeric Functions
ABS
ACOS
ASIN
ATAN
ATAN2
AVG
CEIL
CEILING
COS
COT
COUNT
DEGREES
DIV
EXP
FLOOR
GREATEST
LEAST
LN
LOG
LOG10
LOG2
MAX
MIN
MOD
PI
POW
POWER
RADIANS
RAND
ROUND
SIGN
SIN
SQRT
SUM
TAN
TRUNCATE
Date Functions
ADDDATE
ADDTIME
CURDATE
CURRENT_DATE
CURRENT_TIME
CURRENT_TIMESTAMP
CURTIME
DATE
DATEDIFF
DATE_ADD
DATE_FORMAT
DATE_SUB
DAY
DAYNAME
DAYOFMONTH
DAYOFWEEK
DAYOFYEAR
EXTRACT
FROM_DAYS
HOUR
LAST_DAY
LOCALTIME
LOCALTIMESTAMP
MAKEDATE
MAKETIME
MICROSECOND
MINUTE
MONTH
MONTHNAME
NOW
PERIOD_ADD
PERIOD_DIFF
QUARTER
SECOND
SEC_TO_TIME
STR_TO_DATE
SUBDATE
SUBTIME
SYSDATE
TIME
TIME_FORMAT
TIME_TO_SEC
TIMEDIFF
TIMESTAMP
TO_DAYS
WEEK
WEEKDAY
WEEKOFYEAR
YEAR
YEARWEEK
Advanced Functions
BIN
BINARY
CASE
CAST
COALESCE
CONNECTION_ID
CONV
CONVERT
CURRENT_USER
DATABASE
IF
IFNULL
ISNULL
LAST_INSERT_ID
NULLIF
SESSION_USER
SYSTEM_USER
USER
VERSION
SQL Server Functions
String Functions
ASCII
CHAR
CHARINDEX
CONCAT
Concat with +
CONCAT_WS
DATALENGTH
DIFFERENCE
FORMAT
LEFT
LEN
LOWER
LTRIM
NCHAR
PATINDEX
QUOTENAME
REPLACE
REPLICATE
REVERSE
RIGHT
RTRIM
SOUNDEX
SPACE
STR
STUFF
SUBSTRING
TRANSLATE
TRIM
UNICODE
UPPER
Numeric Functions
ABS
ACOS
ASIN
ATAN
ATN2
AVG
CEILING
COUNT
COS
COT
DEGREES
EXP
FLOOR
LOG
LOG10
MAX
MIN
PI
POWER
RADIANS
RAND
ROUND
SIGN
SIN
SQRT
SQUARE
SUM
TAN
Date Functions
CURRENT_TIMESTAMP
DATEADD
DATEDIFF
DATEFROMPARTS
DATENAME
DATEPART
DAY
GETDATE
GETUTCDATE
ISDATE
MONTH
SYSDATETIME
YEAR
Advanced Functions
CAST
COALESCE
CONVERT
CURRENT_USER
IIF
ISNULL
ISNUMERIC
NULLIF
SESSION_USER
SESSIONPROPERTY
SYSTEM_USER
USER_NAME
MS Access Functions
String Functions
Asc
Chr
Concat with &
CurDir
Format
InStr
InstrRev
LCase
Left
Len
LTrim
Mid
Replace
Right
RTrim
Space
Split
Str
StrComp
StrConv
StrReverse
Trim
UCase
Numeric Functions
Abs
Atn
Avg
Cos
Count
Exp
Fix
Format
Int
Max
Min
Randomize
Rnd
Round
Sgn
Sqr
Sum
Val
Date Functions
Date
DateAdd
DateDiff
DatePart
DateSerial
DateValue
Day
Format
Hour
Minute
Month
MonthName
Now
Second
Time
TimeSerial
TimeValue
Weekday
WeekdayName
Year
Other Functions
CurrentUser
Environ
IsDate
IsNull
IsNumeric
SQL Quick Ref
RemarksRemarks
Значения start и length должны быть указаны в виде количества символов для типов данных ntext, char или varchar и байтов для типов данных text, image, binary или varbinary.The values for start and length must be specified in number of characters for ntext, char, or varchar data types and bytes for text, image, binary, or varbinary data types.
Аргумент expression должен иметь тип varchar(max) или varbinary(max) , если аргумент start или length содержит значение, превышающее 2 147 483 647.The expression must be varchar(max) or varbinary(max) when the start or length contains a value larger than 2147483647.
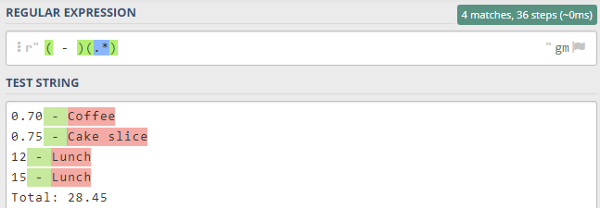
str.replace(str|regexp, str|func)
Это универсальный метод поиска-и-замены, один из самых полезных. Этакий швейцарский армейский нож для поиска и замены в строке.
Мы можем использовать его и без регулярных выражений, для поиска-и-замены подстроки:
Хотя есть подводный камень.
Когда первый аргумент является строкой, он заменяет только первое совпадение.
Вы можете видеть это в приведённом выше примере: только первый заменяется на .
Чтобы найти все дефисы, нам нужно использовать не строку , а регулярное выражение с обязательным флагом :
Второй аргумент – строка замены. Мы можем использовать специальные символы в нем:
| Спецсимволы | Действие в строке замены |
|---|---|
| вставляет | |
| вставляет всё найденное совпадение | |
| вставляет часть строки до совпадения | |
| вставляет часть строки после совпадения | |
| если это 1-2 значное число, то вставляет содержимое n-й скобки | |
| вставляет содержимое скобки с указанным именем |
Например:
Для ситуаций, которые требуют «умных» замен, вторым аргументом может быть функция.
Она будет вызываться для каждого совпадения, и её результат будет вставлен в качестве замены.
Функция вызывается с аргументами :
- – найденное совпадение,
- – содержимое скобок (см. главу Скобочные группы).
- – позиция, на которой найдено совпадение,
- – исходная строка,
- – объект с содержимым именованных скобок (см. главу Скобочные группы).
Если скобок в регулярном выражении нет, то будет только 3 аргумента: .
Например, переведём выбранные совпадения в верхний регистр:
Заменим каждое совпадение на его позицию в строке:
В примере ниже две скобки, поэтому функция замены вызывается с 5-ю аргументами: первый – всё совпадение, затем два аргумента содержимое скобок, затем (в примере не используются) индекс совпадения и исходная строка:
Если в регулярном выражении много скобочных групп, то бывает удобно использовать остаточные аргументы для обращения к ним:
Или, если мы используем именованные группы, то объект с ними всегда идёт последним, так что можно получить его так:
Использование функции даёт нам максимальные возможности по замене, потому что функция получает всю информацию о совпадении, имеет доступ к внешним переменным и может делать всё что угодно.
Разделение строк на подстроки в C#
Разделение строк на подстроки в C# также является достаточно частой задачей в программировании. Для этого можно воспользоваться методом
public String[] Split(String[]? separator, int count, StringSplitOptions options);
public String[] Split(String? separator, int count, StringSplitOptions options = StringSplitOptions.None);
public String[] Split(String[]? separator, StringSplitOptions options);
public String[] Split(char[]? separator, int count, StringSplitOptions options);
public String[] Split(String? separator, StringSplitOptions options = StringSplitOptions.None);
public String[] Split(char[]? separator, StringSplitOptions options);
public String[] Split(char separator, StringSplitOptions options = StringSplitOptions.None);
public String[] Split(params char[]? separator);
public String[] Split(char[]? separator, int count);
public String[] Split(char separator, int count, StringSplitOptions options = StringSplitOptions.None);
В качестве параметров метод принимает один или несколько символов (), используемых в качестве разделителя, а на выходе возвращает массив строк. Рассмотрим работу метода на примере
string s14 = "Эта строка, которая будет разделена на подстроки с использованием двух разделителей";
string[] res = s14.Split(new char[] { ' ', ',' });
foreach (string s in res)
{
    Console.WriteLine(s);
}
Здесь в качестве разделителей мы используем два символа — пробел и запятую. Результатом выполнения кода будет следующий вывод в консоли:
Эта
строка
которая
будет
разделена
на
подстроки
с
использованием
двух
разделителей
JavaScript
JS Array
concat()
constructor
copyWithin()
entries()
every()
fill()
filter()
find()
findIndex()
forEach()
from()
includes()
indexOf()
isArray()
join()
keys()
length
lastIndexOf()
map()
pop()
prototype
push()
reduce()
reduceRight()
reverse()
shift()
slice()
some()
sort()
splice()
toString()
unshift()
valueOf()
JS Boolean
constructor
prototype
toString()
valueOf()
JS Classes
constructor()
extends
static
super
JS Date
constructor
getDate()
getDay()
getFullYear()
getHours()
getMilliseconds()
getMinutes()
getMonth()
getSeconds()
getTime()
getTimezoneOffset()
getUTCDate()
getUTCDay()
getUTCFullYear()
getUTCHours()
getUTCMilliseconds()
getUTCMinutes()
getUTCMonth()
getUTCSeconds()
now()
parse()
prototype
setDate()
setFullYear()
setHours()
setMilliseconds()
setMinutes()
setMonth()
setSeconds()
setTime()
setUTCDate()
setUTCFullYear()
setUTCHours()
setUTCMilliseconds()
setUTCMinutes()
setUTCMonth()
setUTCSeconds()
toDateString()
toISOString()
toJSON()
toLocaleDateString()
toLocaleTimeString()
toLocaleString()
toString()
toTimeString()
toUTCString()
UTC()
valueOf()
JS Error
name
message
JS Global
decodeURI()
decodeURIComponent()
encodeURI()
encodeURIComponent()
escape()
eval()
Infinity
isFinite()
isNaN()
NaN
Number()
parseFloat()
parseInt()
String()
undefined
unescape()
JS JSON
parse()
stringify()
JS Math
abs()
acos()
acosh()
asin()
asinh()
atan()
atan2()
atanh()
cbrt()
ceil()
clz32()
cos()
cosh()
E
exp()
expm1()
floor()
fround()
LN2
LN10
log()
log10()
log1p()
log2()
LOG2E
LOG10E
max()
min()
PI
pow()
random()
round()
sign()
sin()
sqrt()
SQRT1_2
SQRT2
tan()
tanh()
trunc()
JS Number
constructor
isFinite()
isInteger()
isNaN()
isSafeInteger()
MAX_VALUE
MIN_VALUE
NEGATIVE_INFINITY
NaN
POSITIVE_INFINITY
prototype
toExponential()
toFixed()
toLocaleString()
toPrecision()
toString()
valueOf()
JS OperatorsJS RegExp
constructor
compile()
exec()
g
global
i
ignoreCase
lastIndex
m
multiline
n+
n*
n?
n{X}
n{X,Y}
n{X,}
n$
^n
?=n
?!n
source
test()
toString()
(x|y)
.
\w
\W
\d
\D
\s
\S
\b
\B
\0
\n
\f
\r
\t
\v
\xxx
\xdd
\uxxxx
JS Statements
break
class
continue
debugger
do…while
for
for…in
for…of
function
if…else
return
switch
throw
try…catch
var
while
JS String
charAt()
charCodeAt()
concat()
constructor
endsWith()
fromCharCode()
includes()
indexOf()
lastIndexOf()
length
localeCompare()
match()
prototype
repeat()
replace()
search()
slice()
split()
startsWith()
substr()
substring()
toLocaleLowerCase()
toLocaleUpperCase()
toLowerCase()
toString()
toUpperCase()
trim()
valueOf()
Обрабатываем строку в Python
Представим, что ожидается ввод числа с клавиатуры. Перед преобразованием введенной нами строки в число можно легко проверить, введено ли действительно число. Если это так, выполнится операция преобразования. Для обработки строки используем такой метод в Python, как isnumeric():
string = input("Введите какое-нибудь число: ")
if string.isnumeric():
    number = int(string)
    print(number)
Следующий пример позволяет удалять пробелы в конце и начале строки:
string = "   привет мир!  "
string = string.strip()
print(string)           # привет мир!
Так можно дополнить строку пробелами и выполнить выравнивание:
print("iPhone 7:", "52000".rjust(10))
print("Huawei P10:", "36000".rjust(10))
В консоли Python будет выведено следующее:
iPhone 7      52000
Huawei P10      36000
Разделение на подстроки в Python
Для разделения в Python используется метод split(). В зависимости от разделителя он разбивает строку на перечень подстрок. В роли разделителя в данном случае может быть любой символ либо последовательность символов. Этот метод имеет следующие формы:
• split(): в роли разделителя применяется такой символ, как пробел;
• split(delimeter): в роли разделителя применяется delimeter;
• split(delimeter, num): параметром num указывается, какое количество вхождений delimeter применяется для разделения. При этом оставшаяся часть строки добавляется в перечень без разделения на подстроки.
String HTML Wrapper Methods
The HTML wrapper methods return the string wrapped inside the appropriate
HTML tag.
These are not standard methods, and may not work as
expected in all browsers.
| Method | Description |
|---|---|
| anchor() | Creates an anchor |
| big() | Displays a string using a big font |
| blink() | Displays a blinking string |
| bold() | Displays a string in bold |
| fixed() | Displays a string using a fixed-pitch font |
| fontcolor() | Displays a string using a specified color |
| fontsize() | Displays a string using a specified size |
| italics() | Displays a string in italic |
| link() | Displays a string as a hyperlink |
| small() | Displays a string using a small font |
| strike() | Displays a string with a strikethrough |
| sub() | Displays a string as subscript text |
| sup() | Displays a string as superscript text |
❮ Previous
Next ❯