Ascii
Содержание:
- ASCII-код. Структура кодовой таблицы
- Управляющие символы
- 1251 – кодовая страница Windows
- 866 – кодовая страница DOS
- Кодировка UNICODE
- Переход к Unicode
- Кодировки стандарта ASCII[править]
- Номера символов в таблице
- ASCII таблица кодов символов Windows (Win-1251)
- ASCII таблица кодов символов Windows. Описание специальных (управляющих) символов
- Задания[править]
- Еще немного подробностей и сама таблица ASCII
- Базовая таблица кодировки ASCII
- Проблемы ASCII
- UTF-8
- ASCII таблица кодов символов Windows. Описание специальных (управляющих) символов
- Решение[править]
- ASCII Printable Characters
- Национальные варианты ASCII
- Примеры[править]
- История
- ISO/IEC 8859
ASCII-код. Структура кодовой таблицы
- Подробности
- Родительская категория: Кодирование символов
- Категория: Кодирование символов
American Standard Code for Information Interchange (см. таблицу ниже) использовал 7 битов. Всего можно было изобразить до 128 символов, но из них печатных было 96. 8-й бит использовали по-разному:
- для контроля четности;
- как признак «нет/есть данные»;
- для расширения набора изображаемых символов;
- никак не использовали.

Примечание: В дальнейшем изложении все приводимые коды даны в десятичном виде, если система счисления не обозначена явно.
Алфавитно-цифровые символы и символ пробела
Они занимают часть кодов, начиная с 48, и упорядочены, что позволяет легко:
производить преобразование из числового представления в символьное:
код_цифры = число + 30h
переходить от порядкового номера в алфавите к коду буквы — для латинского алфавита:
код_прописной_буквы = порядковый_номер + 40h
код_строчной_буквы = порядковый_номер + 60h
Кроме того, упорядочение позволяет легко программировать сортировку записей, включая и левые пробелы, по алфавиту или по возрастанию чисел.
Арифметические знаки и знаки препинания расположены с алфавитно-цифровыми “вперемешку”.
Управляющие символы
В технике передачи символьной информации (телеграфии) надо было передавать не только печатные символы, но и дополнительную управляющую информацию, такую, как:
- переход к следующей строке;
- переход к началу строки;
- отмена последнего переданного символа, ….;
- и еще многие другие.
Для этого в таблице ASCII была выделена часть кодов с 0 по 31. Некоторые наиболее употребительные управляющие коды с их обозначениями, пришедшими из техники телеграфной связи, даны в таблице (см. таблицу ниже):

Управляющие символы называют Control-кодами (от английского слова «управление»).
На старых примитивных устройствах символьного ввода-вывода — телетайпах — с каждой клавишей был однозначно связан формируемый код. Для формирования же управляющих кодов на телетайпах делалась специальная клавиша Control, удержание которой «обнуляло» три старших бита в коде, формируемом при нажатии «обычной» алфавитно-цифровой клавиши. Например, для ввода управляющего символа ESC с кодом 1Bh надо было нажать клавишу с символом ; (код 3Bh) или клавишу с символом (код 5Bh). Любой из этих кодов при обнуленных трех старших битах давал код 1Bh (символа ESC). Отсюда название клавиши Ctrl на современных клавиатурах.
Среди управляющих символов отметим символы, ипользуемые для расширения количества изображаемых символов. Это прежде всего SO (код 14) и SI (код 15), которые и раньше использовались для переключения наборов символов (например латинского и русского при 7-битовой кодировке).
Кроме того, это символ ESC (код 27). С этого кода начинаются последовательности символов, называемые управляющими. Эти последовательности также используются для переключения кодовых таблиц, а, кроме того, для изменения многих других свойств символьных устройств (клавиатур, дисплеев, принтеров и т.п.). Управляющие языки принтеров (фирм Epson, Hewlett-Paccard) основаны на таких Esc-последовательностях. Принцип формирования Esc-последовательности состоит в следующем: если в потоке кодов встретился код ESC, то несколько следующих кодов не являются кодами изображаемых символов (хотя и могут совпадать с ними), а несут информацию о команде для устройства.
Например, для Epson-совместимых принтеров:
Esc ! n — Эта последовательность из трех символов выдается на принтер в общем потоке символов. Символы ! n не печатаются, а вызывают переключение на встроенный шрифт принтера с номером n (диапазон номеров зависит от модели принтера). Это пример простой команды. Длина последовательности переменная и определяется видом команды. В данном случае символ ! говорит, что требуется переключить шрифт и что еще один символ (байт ) не должен печататься, а несет информацию о номере шрифта.
А вот более сложная команда: Esc & 0 n1nka1d1…dm. Символы & 0 после Esc говорят, что это команда, которая переопределяет конфигурацию символов текущего фонта, загруженного в ОЗУ принтера. Байты n1 и nk задают начальный и конечный коды диапазона символов, очертания которых будут переопределяться. Байт a1 задает размер матрицы, в которой рисуется символ. Байты d1 … dm определяют конфигурацию символов.
- < Назад
- Вперёд >
Управляющие символы
Таблица ASCII создавалась для обмена информацией по телетайпу. В набор были включены непечатаемые символы, используемые как команды для управления устройством телетайп. Аналогичные команды применялись и в других докомпьютерных средствах обмена сообщениями (азбука Морзе, семафорная азбука), учитывая специфику устройства.
Примечание: далее в списке — коды символов записаны в шестнадцатеричной системе счисления, после названий символов.
NUL, 00 — null («пустой»). Символ null всегда игнорировался. На перфолентах, цифра «1» обозначалась отверстием, а цифра «0» — отсутствием отверстия. Участки перфоленты, на которых не была записана информация — не содержали отверстий (то есть содержали символы null); такие участки располагались в начале и в конце ленты. Символ null по сей день используется во многих языках программирования (как признак конца строки) и обозначается «\0». (Термин «строка» обозначает последовательность символов.) В некоторых операционных системах, null — последний символ любого текстового файла.
Сообщения, передаваемые по каналу связи, делились на две части:
- Заголовок;
- Текст.
«Заголовок» содержал: адреса отправителя и получателя, контрольную сумму и т. п.; мог размещаться до «текста» или после. Термином «текст» называлась часть сообщения, предназначенная для печати.
1251 – кодовая страница Windows
| 128 Ђ | 144 Ђ | 160 | 176 ° | 192 А | 208 Р | 224 а | 240 р |
| 129 Ѓ | 145 ‘ | 161 Ў | 177 ± | 193 Б | 209 С | 225 б | 241 с |
| 130 ‚ | 146 ’ | 162 ў | 178 I | 194 В | 210 Т | 226 в | 242 т |
| 131 ѓ | 147 “ | 163 J | 179 i | 195 Г | 211 У | 227 г | 243 у |
| 132 „ | 148 ” | 164 ¤ | 180 ґ | 196 Д | 212 Ф | 228 д | 244 ф |
| 133 … | 149 • | 165 Ґ | 181 μ | 197 Е | 213 Х | 229 е | 245 х |
| 134 † | 150 – | 166 ¦ | 182 ¶ | 198 Ж | 214 Ц | 230 ж | 246 ц |
| 135 ‡ | 151 — | 167 § | 183 · | 199 З | 215 Ч | 231 з | 247 ч |
| 136 € | 152 □ | 168 Ё | 184 ё | 200 И | 216 Ш | 232 и | 248 ш |
| 137 ‰ | 153 | 169 | 185 № | 201 Й | 217 Щ | 233 й | 249 щ |
| 138 Љ | 154 љ | 170 Є | 186 є | 202 К | 218 Ъ | 234 к | 250 ъ |
| 139 < | 155 > | 171 « | 187 » | 203 Л | 219 Ы | 235 л | 251 ы |
| 140 Њ | 156 њ | 172 ¬ | 188 j | 204 М | 220 Ь | 236 м | 252 ь |
| 141 Ќ | 157 ќ | 173 | 189 S | 205 Н | 221 Э | 237 н | 253 э |
| 142 Ћ | 158 ћ | 174 | 190 s | 206 О | 222 Ю | 238 о | 254 ю |
| 143 Џ | 159 џ | 175 Ï | 191 ї | 207 П | 223 Я | 239 п | 255 я |
866 – кодовая страница DOS
| 128 А | 144 Р | 160 а | 176 ░ | 192 └ | 208 ╨ | 224 р | 240 ≡Ё |
| 129 Б | 145 С | 161 б | 177 ▒ | 193 ┴ | 209 ╤ | 225 с | 241 ±ё |
| 130 В | 146 Т | 162 в | 178 ▓ | 194 ┬ | 210 ╥ | 226 т | 242 ≥ |
| 131 Г | 147 У | 163 г | 179 │ | 195 ├ | 211 ╙ | 227 у | 243 ≤ |
| 132 Д | 148 Ф | 164 д | 180 ┤ | 196 ─ | 212 ╘ | 228 ф | 244 ⌠ |
| 133 Е | 149 Х | 165 е | 181 ╡ | 197 ┼ | 213 ╒ | 229 х | 245 ⌡ |
| 134 Ж | 150 Ц | 166 ж | 182 ╢ | 198 ╞ | 214 ╓ | 230 ц | 246 ¸ |
| 135 З | 151 Ч | 167 з | 183 ╖ | 199 ╟ | 215 ╫ | 231 ч | 247 » |
| 136 И | 152 Ш | 168 и | 184 ╕ | 200 ╚ | 216 ╪ | 232 ш | 248 ° |
| 137 Й | 153 Щ | 169 й | 185 ╣ | 201 ╔ | 217 ┘ | 233 щ | 249 · |
| 138 К | 154 Ъ | 170 к | 186 ║ | 202 ╩ | 218 ┌ | 234 ъ | 250 ∙ |
| 139 Л | 155 Ы | 171 л | 187 ╗ | 203 ╦ | 219 █ | 235 ы | 251 √ |
| 140 М | 156 Ь | 172 м | 188 ╝ | 204 ╠ | 220 ▄ | 236 ь | 252 ⁿ |
| 141 Н | 157 Э | 173 н | 189 ╜ | 205 ═ | 221 ▌ | 237 э | 253 ² |
| 142 О | 158 Ю | 174 о | 190 ╛ | 206 ╬ | 222 ▐ | 238 ю | 254 ■ |
| 143 П | 159 Я | 175 п | 191 ┐ | 207 ╧ | 223 ▀ | 239 я | 255 |
Русские названия основных спецсимволов:
| Символ | Название |
| ` | гравис, кавычка, обратный машинописный апостроф |
| ` | гравис, кавычка, обратный машинописный апостроф |
| ~ | тильда |
| ! | восклицательный знак |
| @ | эт, коммерческое эт, «собака» |
| # | октоторп, решетка, диез |
| $ | знак доллара |
| % | процент |
| ^ | циркумфлекс, знак вставки |
| & | амперсанд |
| * | астериск, звездочка, знак умножения |
| ( | левая открывающая круглая скобка |
| ) | правая закрывающая круглая скобка |
| — | минус, дефис |
| _ | знак подчеркивания |
| = | знак равенства |
| + | плюс |
| левая открывающая квадратная скобка | |
| правая закрывающая квадратная скобка | |
| { | левая открывающая фигурная скобка |
| } | правая закрывающая фигурная скобка |
| ; | точка с запятой |
| двоеточие | |
| ‘ | машинописный апостроф, одинарная кавычка |
| « | двойная кавычка |
| , | запятая |
| . | точка |
| слэш, косая черта, знак дроби | |
| < | левая открытая угловая скобка, знак меньше |
| > | правая закрытая угловая скобка, знак больше |
| \ | обратный слэш, обратная косая черта |
| | | вертикальная черта |
Кодировка UNICODE
Юникод (Unicode) — стандарт кодирования символов, позволяющий представить знаки практически всех письменных языков. Стандарт предложен в 1991 году некоммерческой организацией «Консорциум Юникода».
В Unicode используются 16-битовые (2-байтовые) коды, что позволяет представить 65536 символов.
Применение стандарта Unicode позволяет закодировать очень большое число символов из разных письменностей: в документах Unicode могут соседствовать китайские иероглифы, математические символы, буквы греческого алфавита, латиницы и кириллицы, при этом становится ненужным переключение кодовых страниц.
Для представления символьных данных в кодировке Unicode используется символьный тип wchar_t.
| ASCII | UNICODE |
| char | wchar_t |
| 1 байт | 2 байта |
Тип кодировки задается в свойствах проекта Microsoft Visual Studio:

Многобайтовая кодировка предполагает использование кодировки ASCII.
При этом при построении проекта используется директива условной компиляции, переопределяющая тип TCHAR:
#ifdef _UNICODE typedef wchar_t TCHAR;#else typedef char TCHAR;#endif
_T(«строка»)tchar.hПредставление данных и архитектура ЭВМ
Переход к Unicode
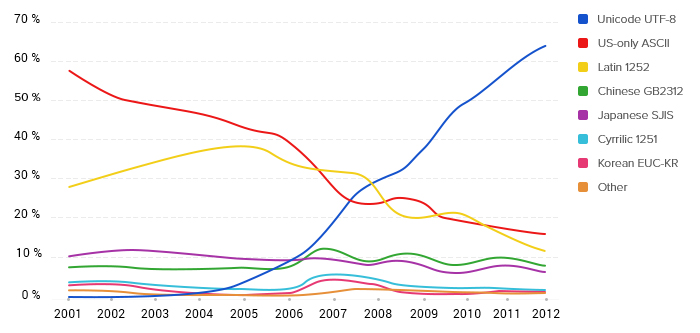
Развитие интернета, увеличение количества компьютеров и удешевление памяти привели к тому, что проблемы, которые доставляла путаница в кодировках, стали перевешивать некоторую экономию памяти. Особенно ярко это проявлялось в интернете, когда текст написанный на одном компьютере должен был корректно отображаться на многих других устройствах. Это доставляло огромные проблемы как программистам, которые должны были решать какую кодировку использовать, так и конечным пользователям, которые не могли получить доступ к интересующим их текстам.
В результате в октябре 1991 года появилась первая версия одной общей таблицы символов, названной Unicode. Она включала в себя на тот момент 7161 различный символ из 24 письменностей мира.
В Unicode постепенно добавлялись новые языки и символы. Например, в версию 1.0.1 в середине 1992 года добавили более 20 000 идеограмм китайского, японского и корейского языков. В актуальной на текущий момент версии содержится уже более 143 000 символов.
Кодировки стандарта ASCII[править]
| Определение: |
| ASCII — таблицы кодировок, в которых содержатся основные символы (английский алфавит, цифры, знаки препинания, символы национальных алфавитов(свои для каждого региона), служебные символы) и длина кода каждого символа бит. |
бит:
ASCII7 — первая кодировка, пригодная для работы с текстом. Помимо маленьких букв английского алфавита и служебных символов, содержит большие буквы английского языка, цифры, знаки препинания и другие символы.
Кодировки стандарта ASCII ( бит):
- ASCII — первая кодировка, в которой стало возможно использовать символы национальных алфавитов.
- КОИ8-R — первая русская кодировка. Символы кириллицы расположены не в алфавитном порядке. Их разместили в верхнюю половину таблицы так, чтобы позиции кириллических символов соответствовали их фонетическим аналогам в английском алфавите. Это значит, что даже при потере старшего бита каждого символа, например, при проходе через устаревший семибитный модем, текст остается «читаемым».
- CP866 — русская кодировка, использовавшаяся на компьютерах IBM в системе DOS.
- Windows-1251 — русская кодировка, использовавшаяся в русскоязычных версиях операционной системы Windows в начале 90-х годов. Кириллические символы идут в алфавитном порядке. Содержит все символы, встречающиеся в типографике обычного текста (кроме знака ударения).
Структурные свойства таблицыправить
- Цифры 0-9 представляются своими двоичными значениями (например, ), перед которыми стоит . Таким образом, двоично-десятичные числа (BCD) превращаются в ASCII-строку с помощью простого добавления слева к каждому двоично-десятичному полубайту.
- Буквы A-Z верхнего и нижнего регистров различаются в своём представлении только одним битом, что упрощает преобразование регистра и проверку на диапазон. Буквы представляются своими порядковыми номерами в алфавите, записанными в двоичной системе счисления, перед которыми стоит (для букв верхнего регистра) или (для букв нижнего регистра).
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | A | B | C | D | E | F | ||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| NUL | SOH | STX | ETX | EOT | ENQ | ACK | BEL | BS | TAB | LF | VT | FF | CR | SO | SI | |
| 1 | DLE | DC1 | DC2 | DC3 | DC4 | NAK | SYN | ETB | CAN | EM | SUB | ESC | FS | GS | RS | US |
| 2 | ! | » | # | $ | % | & | ‘ | ( | ) | * | + | , | — | . | ||
| 3 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | ; | < | = | > | ? | ||
| 4 | @ | A | B | C | D | E | F | G | H | I | J | K | L | M | N | O |
| 5 | P | Q | R | S | T | U | V | W | X | Y | Z | \ | ^ | _ | ||
| 6 | ` | a | b | c | d | e | f | g | h | i | j | k | l | m | n | o |
| 7 | p | q | r | s | t | u | v | w | x | y | z | { | | | } | ~ | DEL |
Номера символов в таблице
Если человек занимается разработкой программного обеспечения или выполняет некоторые другие задачи из области информационных технологий, ему необходимо знать номера ряда символов ASCII.
Как упоминалось выше, позиции 0-31 и 127 занимают управляющие символы. Номер 32 закреплен за пробелом, номера 33-47 и 58-64 отведены под знаки препинания и основные математические операции.

Латинские прописные буквы расположены по алфавиту и имеют номера с 65-го по 90-й. Строчные буквы также расположены по алфавиту, их позиции – с 97-й по 122-ю. Оставшиеся номера (91-96 и 123-126) закреплены за квадратными и фигурными скобками, косой и прямой чертой, а также некоторыми диакритическими знаками.
Полную таблицу символов в удобном графическом представлении можно увидеть на изображении, представленном выше. На рисунке ниже демонстрируются номера знаков в русской таблице символов ASCII.
ASCII таблица кодов символов Windows (Win-1251)
| Dec | Hex | Символ | Dec | Hex | Символ | |
| 000 | 00 | спец. NOP | 128 | 80 | Ђ | |
| 001 | 01 | спец. SOH | 129 | 81 | Ѓ | |
| 002 | 02 | спец. STX | 130 | 82 | ‚ | |
| 003 | 03 | спец. ETX | 131 | 83 | ѓ | |
| 004 | 04 | спец. EOT | 132 | 84 | „ | |
| 005 | 05 | спец. ENQ | 133 | 85 | … | |
| 006 | 06 | спец. ACK | 134 | 86 | † | |
| 007 | 07 | спец. BEL | 135 | 87 | ‡ | |
| 008 | 08 | спец. BS | 136 | 88 | € | |
| 009 | 09 | спец. TAB | 137 | 89 | ‰ | |
| 010 | 0A | спец. LF | 138 | 8A | Љ | |
| 011 | 0B | спец. VT | 139 | 8B | ‹ ‹ | |
| 012 | 0C | спец. FF | 140 | 8C | Њ | |
| 013 | 0D | спец. CR | 141 | 8D | Ќ | |
| 014 | 0E | спец. SO | 142 | 8E | Ћ | |
| 015 | 0F | спец. SI | 143 | 8F | Џ | |
| 016 | 10 | спец. DLE | 144 | 90 | ђ | |
| 017 | 11 | спец. DC1 | 145 | 91 | ‘ | |
| 018 | 12 | спец. DC2 | 146 | 92 | ’ | |
| 019 | 13 | спец. DC3 | 147 | 93 | “ | |
| 020 | 14 | спец. DC4 | 148 | 94 | ” | |
| 021 | 15 | спец. NAK | 149 | 95 | • | |
| 022 | 16 | спец. SYN | 150 | 96 | – | |
| 023 | 17 | спец. ETB | 151 | 97 | — | |
| 024 | 18 | спец. CAN | 152 | 98 | ||
| 025 | 19 | спец. EM | 153 | 99 | ||
| 026 | 1A | спец. SUB | 154 | 9A | љ | |
| 027 | 1B | спец. ESC | 155 | 9B | › | |
| 028 | 1C | спец. FS | 156 | 9C | њ | |
| 029 | 1D | спец. GS | 157 | 9D | ќ | |
| 030 | 1E | спец. RS | 158 | 9E | ћ | |
| 031 | 1F | спец. US | 159 | 9F | џ | |
| 032 | 20 | сцеп. SP (Пробел) | 160 | A0 | ||
| 033 | 21 | ! | 161 | A1 | Ў | |
| 034 | 22 | « | 162 | A2 | ў | |
| 035 | 23 | # | 163 | A3 | Ћ | |
| 036 | 24 | $ | 164 | A4 | ¤ | |
| 037 | 25 | % | 165 | A5 | Ґ | |
| 038 | 26 | & | 166 | A6 | ¦ | |
| 039 | 27 | ‘ | 167 | A7 | § | |
| 040 | 28 | ( | 168 | A8 | Ё | |
| 041 | 29 | ) | 169 | A9 | ||
| 042 | 2A | * | 170 | AA | Є | |
| 043 | 2B | + | 171 | AB | ||
| 044 | 2C | , | 172 | AC | ¬ | |
| 045 | 2D | — | 173 | AD | | |
| 046 | 2E | . | 174 | AE | ||
| 047 | 2F | 175 | AF | Ї | ||
| 048 | 30 | 176 | B0 | ° | ||
| 049 | 31 | 1 | 177 | B1 | ± | |
| 050 | 32 | 2 | 178 | B2 | І | |
| 051 | 33 | 3 | 179 | B3 | і | |
| 052 | 34 | 4 | 180 | B4 | ґ | |
| 053 | 35 | 5 | 181 | B5 | µ | |
| 054 | 36 | 6 | 182 | B6 | ¶ | |
| 055 | 37 | 7 | 183 | B7 | · | |
| 056 | 38 | 8 | 184 | B8 | ё | |
| 057 | 39 | 9 | 185 | B9 | № | |
| 058 | 3A | 186 | BA | є | ||
| 059 | 3B | ; | 187 | BB | ||
| 060 | 3C | < | 188 | BC | ј | |
| 061 | 3D | = | 189 | BD | Ѕ | |
| 062 | 3E | > | 190 | BE | ѕ | |
| 063 | 3F | ? | 191 | BF | ї | |
| 064 | 40 | @ | 192 | C0 | А | |
| 065 | 41 | A | 193 | C1 | Б | |
| 066 | 42 | B | 194 | C2 | В | |
| 067 | 43 | C | 195 | C3 | Г | |
| 068 | 44 | D | 196 | C4 | Д | |
| 069 | 45 | E | 197 | C5 | Е | |
| 070 | 46 | F | 198 | C6 | Ж | |
| 071 | 47 | G | 199 | C7 | З | |
| 072 | 48 | H | 200 | C8 | И | |
| 073 | 49 | I | 201 | C9 | Й | |
| 074 | 4A | J | 202 | CA | К | |
| 075 | 4B | K | 203 | CB | Л | |
| 076 | 4C | L | 204 | CC | М | |
| 077 | 4D | M | 205 | CD | Н | |
| 078 | 4E | N | 206 | CE | О | |
| 079 | 4F | O | 207 | CF | П | |
| 080 | 50 | P | 208 | D0 | Р | |
| 081 | 51 | Q | 209 | D1 | С | |
| 082 | 52 | R | 210 | D2 | Т | |
| 083 | 53 | S | 211 | D3 | У | |
| 084 | 54 | T | 212 | D4 | Ф | |
| 085 | 55 | U | 213 | D5 | Х | |
| 086 | 56 | V | 214 | D6 | Ц | |
| 087 | 57 | W | 215 | D7 | Ч | |
| 088 | 58 | X | 216 | D8 | Ш | |
| 089 | 59 | Y | 217 | D9 | Щ | |
| 090 | 5A | Z | 218 | DA | Ъ | |
| 091 | 5B | 219 | DB | Ы | ||
| 092 | 5C | \ | 220 | DC | Ь | |
| 093 | 5D | 221 | DD | Э | ||
| 094 | 5E | ^ | 222 | DE | Ю | |
| 095 | 5F | _ | 223 | DF | Я | |
| 096 | 60 | ` | 224 | E0 | а | |
| 097 | 61 | a | 225 | E1 | б | |
| 098 | 62 | b | 226 | E2 | в | |
| 099 | 63 | c | 227 | E3 | г | |
| 100 | 64 | d | 228 | E4 | д | |
| 101 | 65 | e | 229 | E5 | е | |
| 102 | 66 | f | 230 | E6 | ж | |
| 103 | 67 | g | 231 | E7 | з | |
| 104 | 68 | h | 232 | E8 | и | |
| 105 | 69 | i | 233 | E9 | й | |
| 106 | 6A | j | 234 | EA | к | |
| 107 | 6B | k | 235 | EB | л | |
| 108 | 6C | l | 236 | EC | м | |
| 109 | 6D | m | 237 | ED | н | |
| 110 | 6E | n | 238 | EE | о | |
| 111 | 6F | o | 239 | EF | п | |
| 112 | 70 | p | 240 | F0 | р | |
| 113 | 71 | q | 241 | F1 | с | |
| 114 | 72 | r | 242 | F2 | т | |
| 115 | 73 | s | 243 | F3 | у | |
| 116 | 74 | t | 244 | F4 | ф | |
| 117 | 75 | u | 245 | F5 | х | |
| 118 | 76 | v | 246 | F6 | ц | |
| 119 | 77 | w | 247 | F7 | ч | |
| 120 | 78 | x | 248 | F8 | ш | |
| 121 | 79 | y | 249 | F9 | щ | |
| 122 | 7A | z | 250 | FA | ъ | |
| 123 | 7B | { | 251 | FB | ы | |
| 124 | 7C | | | 252 | FC | ь | |
| 125 | 7D | } | 253 | FD | э | |
| 126 | 7E | ~ | 254 | FE | ю | |
| 127 | 7F | Спец. DEL | 255 | FF | я |
ASCII таблица кодов символов Windows. Описание специальных (управляющих) символов
Следует отметить, что первоначально управляющие символы таблицы ASCII использовались
для обеспечения обмена данными по телетайпу, ввода данных с перфоленты и
для простейшего управления внешними устройствами.
В настоящее время большинство из управляющих символов ASCII таблицы
уже не несут эту нагрузку и могут использоваться для иных целей.
| Код | Описание |
|---|---|
| NUL, 00 | Null, пустой |
| SOH, 01 | Start Of Heading, начало заголовка |
| STX, 02 | Start of TeXt, начало текста. |
| ETX, 03 | End of TeXt, конец текста |
| EOT, 04 | End of Transmission, конец передачи |
| ENQ, 05 | Enquire. Прошу подтверждения |
| ACK, 06 | Acknowledgement. Подтверждаю |
| BEL, 07 | Bell, звонок |
| BS, 08 | Backspace, возврат на один символ назад |
| TAB, 09 | Tab, горизонтальная табуляция |
| LF, 0A | Line Feed, перевод строки. Сейчас в большинстве языков программирования обозначается как \n |
| VT, 0B | Vertical Tab, вертикальная табуляция. |
| FF, 0C | Form Feed, прогон страницы, новая страница |
| CR, 0D | Carriage Return, возврат каретки. Сейчас в большинстве языков программирования обозначается как \r |
| SO, 0E | Shift Out, изменить цвет красящей ленты в печатающем устройстве |
| SI, 0F | Shift In, вернуть цвет красящей ленты в печатающем устройстве обратно |
| DLE, 10 | Data Link Escape, переключение канала на передачу данных |
| DC1, 11 DC2, 12DC3, 13DC4, 14 | Device Control, символы управления устройствами |
| NAK, 15 | Negative Acknowledgment, не подтверждаю. |
| SYN, 16 | Synchronization. Символ синхронизации |
| ETB, 17 | End of Text Block, конец текстового блока |
| CAN, 18 | Cancel, отмена переданного ранее |
| EM, 19 | End of Medium, конец носителя данных |
| SUB, 1A | Substitute, подставить. Ставится на месте символа, значение которого было потеряно или испорчено при передаче |
| ESC, 1B | Escape Управляющая последовательность |
| FS, 1C | File Separator, разделитель файлов |
| GS, 1D | Group Separator, разделитель групп |
| RS, 1E | Record Separator, разделитель записей |
| US, 1F | Unit Separator, разделитель юнитов |
| DEL, 7F | Delete, стереть последний символ. |
Задания[править]
Проверьте работу программы вводом строки В коде ASCII, выводом программы окажется (где 10 — управляющий код разрыва строки.)
Введите строку . В зависимости от системы и ее настроек (так называемой локали), вывод может содержать 8 (при использовании однобайтных кириллических кодировок) или 14 кодов (UTF-8).
Изучите коды, формируемые такими клавишами и сочетаниями, как ESC, F5, ↑, Alt-x, Control-r.
Исследуйте работу программы на «нетекстовых» потоках небольшого (до примерно 500 байт) объема — изображениях (, ), упакованных файлах (, ) и др. Попробуйте установить закономерности
(Указание: обратите внимание на значения первых пяти—десяти кодов.)
вариант программы разрывает () выходные строки по границам входных. Реализуйте также разрыв выходных строк по достижению определенного количества выведенных в одной строке кодов (например, каждые 16.)
Разработайте варианты программы, выводящие считанные коды в шестнадцатиричном и восьмеричном представлениях
(Указание: воспользуйтесь материалом раздела Скалярные типы.)
Напишите программу, которая печатает все символы и их ASCII-коды.
Попробуйте напечатать как символ число больше 255. Что получается?
Ознакомьтесь с описанием программы в стандарте POSIX и в документации к пакету GNU Coreutils.
Еще немного подробностей и сама таблица ASCII
Точнее говоря, любую букву, цифру, знак препинания и тд и тп, тобишь любой символ можно ввести не просто вполне естественным образом (естественный способ для простого пользователя — это тычок пальчиком в соответствующую кнопку на клавиатуре), а еще и методом использования кнопки ALT и цифровой клавиатуры, а именно нажатие ALT+35 (где кнопка ALT зажата, а 35 вводится на цифрах (плюс жать не надо)) даст символ #.

Сочетание ALT+147 даст Вам букву У. Собственно, подобным образом можно вводить и специфичные символы, а именно, скажем — это нажатие ALT+1 , а ▀ — это ALT+1247 и тд и тп.
Думаю, чем такой способ ввода безопаснее объяснять не надо — выводы вполне логичны, а о том чем безопаснее добавлять в пароль расширенные символы я писал выше в скобочках.
Кстати о расширенных символах. Среди них есть такая вещь как неразрывный пробел- ALT+0160. Он отображается как обычный пробел и зачастую может обмануть тех, кто каким-то образом подглядел Ваш пароль.
Даже, если Ваш пароль будет записан кейлогером, то в лог-файле он (неразрывный пароль) будет выглядеть, как обычный пробел, что собьет с толку взломщика особенно, если он ведать не ведает ни о каких специфичных символах и неразрывных пробелах, т.е., даже получив пароль он не сможет им воспользоваться.
Базовая таблица кодировки ASCII
| 32 пробел | 48 0 | 64 @ | 80 P | 96 ` | 112 p |
| 33 ! | 49 1 | 65 A | 81 Q | 97 a | 113 q |
| 34 “ | 50 2 | 66 B | 82 R | 98 b | 114 r |
| 35 # | 51 3 | 67 C | 83 S | 99 c | 115 s |
| 36 $ | 52 4 | 68 D | 84 T | 100 d | 116 t |
| 37 % | 53 5 | 69 E | 85 U | 101 e | 117 u |
| 38 & | 54 6 | 70 F | 86 V | 102 f | 118 v |
| 39 ‘ | 55 7 | 71 G | 87 W | 103 g | 119 w |
| 40 ( | 56 8 | 72 H | 88 X | 104 h | 120 x |
| 41 ) | 57 9 | 73 I | 89 Y | 105 i | 121 y |
| 42 * | 58 : | 74 J | 90 Z | 106 j | 122 z |
| 43 + | 59 ; | 75 K | 91 [ | 107 k | 123 { |
| 44 , | 60 < | 76 L | 92 \ | 108 l | 124 | |
| 45 — | 61 = | 77 M | 93 ] | 109 m | 125 } |
| 46 . | 62 > | 78 N | 94 ^ | 110 n | 126 ~ |
| 47 / | 63 ? | 79 O | 95 _ | 111 o | 127 |
Символы с номерами от 128 до 255 представляют собой таблицу расширения и варьируются в зависимости от набора скриптов, представленных кодировкой символов. Набор символов таблицы расширения различается в зависимости от выбранной кодовой страницы:
Проблемы ASCII
Поскольку количество элементов даже в расширенной таблице не превышало 256, возможность вмещения в одну кодировку нескольких различных письменностей отсутствовала. В 90-е годы в Рунете появилась проблема «крокозябр», когда тексты, набранные русскими символами ASCII, отображались некорректно.
Проблема заключалась в несоответствии кодов различных вариантов ASCII друг другу. Вспомним, что на позициях 128-255 могли располагаться различные знаки, и при смене одной кириллической кодировки на другую все буквы текста заменялись на другие, имеющие идентичный номер в другой версии кодировки.
UTF-8
Впервые кодировка UTF-8 была официально представлена на конференции USENIX в Сан Диего в январе 1993. От других мультибайтных кодировок ее отличала полная совместимость с ASCII: все символы ASCII в UTF-8 кодируются 7 битами. Каждый символ кодировки, отличный от ASCII, состоит из ведущего байта, указывающего длину последовательности, и одного или нескольких продолжающих байт. Такой принцип позволяет определить длину последовательности только по первому байту. Коды символов ASCII, ведущих и продолжающих байт не пересекаются, что позволяет легко найти начало последовательности простым откатом назад максимум на пять байт.
В ноябре 2003 года стандартом RFC-3629 максимальная длина последовательности UTF-8 была ограничена четырьмя байтами, однако потенциально UTF-8 позволяет использовать последовательности вплоть до шести байт.
Принцип кодирования
У всех однобайтных символов старший бит кода установлен в и полностью совпадает с кодом символа в ASCII:

У всех многобайтных последовательностей ведущий байт начинается с двух и более единиц в старших битах. Количество единиц ведущего байта соответствует длине мультибайтной последовательности. Все продолжающие байты начинаются с в двух старших битах. Все неиспользуемые схемой кодирования биты мультибайтных последовательностей используются для кодирования символов:

Такой подход создает несколько символьных диапазонов разной величины. Первый диапазон использует 7 бит и кодирует до 128 символов. Второй диапазон использует 11 бит и кодирует до 2 048 символов. Третий и четвертый диапазоны используют 16 бит и 21 бит соответственно и позволяют кодировать до 65 536 и 2 097 152 соответственно. В сумме все четыре диапазона значений позволяют кодировать до 2 164 864 символов.
Кодировка UTF-8 является универсальной и имеет внушительный резерв на будущее. Это делает ее наиболее удобной кодировкой для использования в интернете.
ASCII таблица кодов символов Windows. Описание специальных (управляющих) символов
| Код | Описание |
|---|---|
| NUL, 00 | Null, пустой |
| SOH, 01 | Start Of Heading, начало заголовка |
| STX, 02 | Start of TeXt, начало текста. |
| ETX, 03 | End of TeXt, конец текста |
| EOT, 04 | End of Transmission, конец передачи |
| ENQ, 05 | Enquire. Прошу подтверждения |
| ACK, 06 | Acknowledgement. Подтверждаю |
| BEL, 07 | Bell, звонок |
| BS, 08 | Backspace, возврат на один символ назад |
| TAB, 09 | Tab, горизонтальная табуляция |
| LF, 0A | Line Feed, перевод строки. Сейчас в большинстве языков программирования обозначается как \n |
| VT, 0B | Vertical Tab, вертикальная табуляция. |
| FF, 0C | Form Feed, прогон страницы, новая страница |
| CR, 0D | Carriage Return, возврат каретки. Сейчас в большинстве языков программирования обозначается как \r |
| SO, 0E | Shift Out, изменить цвет красящей ленты в печатающем устройстве |
| SI, 0F | Shift In, вернуть цвет красящей ленты в печатающем устройстве обратно |
| DLE, 10 | Data Link Escape, переключение канала на передачу данных |
| DC1, 11 DC2, 12DC3, 13DC4, 14 | Device Control, символы управления устройствами |
| NAK, 15 | Negative Acknowledgment, не подтверждаю. |
| SYN, 16 | Synchronization. Символ синхронизации |
| ETB, 17 | End of Text Block, конец текстового блока |
| CAN, 18 | Cancel, отмена переданного ранее |
| EM, 19 | End of Medium, конец носителя данных |
| SUB, 1A | Substitute, подставить. Ставится на месте символа, значение которого было потеряно или испорчено при передаче |
| ESC, 1B | Escape Управляющая последовательность |
| FS, 1C | File Separator, разделитель файлов |
| GS, 1D | Group Separator, разделитель групп |
| RS, 1E | Record Separator, разделитель записей |
| US, 1F | Unit Separator, разделитель юнитов |
| DEL, 7F | Delete, стереть последний символ. |
Решение[править]
#include <assert.h>
#include <stdio.h>

int main ()
{
  int c;
  while ((c = getchar ()) != EOF) {
    printf (" %3d%s", c, (c == '\n' ? "\n"  ""));
  }
  assert (! ferror (stdin));

  return ;
}
Главный цикл этой программы напоминает таковой для рассмотренной в разделе Максимум; в частности, мы вновь используем цикл «пока» (). Однако, вместо для чтения чисел, здесь мы обращаемся к функции для чтения отдельных знаков (кодов.) Мы по-прежнему используем — для вывода кода символа в десятичной записи.
С другой стороны, из условия корректности ввода исключается требование возврата именно (как признака исчерпания входного потока), поскольку это условие уже является условием завершения главного цикла. Это различие связано с тем, что в данной программе не требуется опозновать «подходящий» ввод — допустимой является совершенно любая последовательность символов (кодов.) Напротив, мы принимали исключительно целые числа в десятичной записи.
Требование ложности значения функции признака ошибки для стандартного ввода () по завершению главного цикла остается в силе.
Подчеркнем, что диапазон возвращаемых функцией значений — это диапазон «символьного» типа плюс одно значение, а именно — признак конца потока . Как следствие, иногда встречаемое в примерах кода чтение символа из потока непосредственно в переменную типа не вполне корректно — для этих целей следует всегда использовать переменную типа .
Обратите внимание, что сформировать условие «конец потока» при вводе с клавиатуры можно вводом (в зависимости от системы и предполагая настройки по-умолчанию) Control-d или Control-z (также обозначаются C-d, ^D, C-z, ^Z.)
ASCII Printable Characters
| Char | Number | Description |
|---|---|---|
| 0 — 31 | Control characters (see below) | |
| 32 | space | |
| ! | 33 | exclamation mark |
| « | 34 | quotation mark |
| # | 35 | number sign |
| $ | 36 | dollar sign |
| % | 37 | percent sign |
| & | 38 | ampersand |
| ‘ | 39 | apostrophe |
| ( | 40 | left parenthesis |
| ) | 41 | right parenthesis |
| * | 42 | asterisk |
| + | 43 | plus sign |
| , | 44 | comma |
| — | 45 | hyphen |
| . | 46 | period |
| 47 | slash | |
| 48 | digit 0 | |
| 1 | 49 | digit 1 |
| 2 | 50 | digit 2 |
| 3 | 51 | digit 3 |
| 4 | 52 | digit 4 |
| 5 | 53 | digit 5 |
| 6 | 54 | digit 6 |
| 7 | 55 | digit 7 |
| 8 | 56 | digit 8 |
| 9 | 57 | digit 9 |
| 58 | colon | |
| ; | 59 | semicolon |
| < | 60 | less-than |
| = | 61 | equals-to |
| > | 62 | greater-than |
| ? | 63 | question mark |
| @ | 64 | at sign |
| A | 65 | uppercase A |
| B | 66 | uppercase B |
| C | 67 | uppercase C |
| D | 68 | uppercase D |
| E | 69 | uppercase E |
| F | 70 | uppercase F |
| G | 71 | uppercase G |
| H | 72 | uppercase H |
| I | 73 | uppercase I |
| J | 74 | uppercase J |
| K | 75 | uppercase K |
| L | 76 | uppercase L |
| M | 77 | uppercase M |
| N | 78 | uppercase N |
| O | 79 | uppercase O |
| P | 80 | uppercase P |
| Q | 81 | uppercase Q |
| R | 82 | uppercase R |
| S | 83 | uppercase S |
| T | 84 | uppercase T |
| U | 85 | uppercase U |
| V | 86 | uppercase V |
| W | 87 | uppercase W |
| X | 88 | uppercase X |
| Y | 89 | uppercase Y |
| Z | 90 | uppercase Z |
| 91 | left square bracket | |
| \ | 92 | backslash |
| 93 | right square bracket | |
| ^ | 94 | caret |
| _ | 95 | underscore |
| ` | 96 | grave accent |
| a | 97 | lowercase a |
| b | 98 | lowercase b |
| c | 99 | lowercase c |
| d | 100 | lowercase d |
| e | 101 | lowercase e |
| f | 102 | lowercase f |
| g | 103 | lowercase g |
| h | 104 | lowercase h |
| i | 105 | lowercase i |
| j | 106 | lowercase j |
| k | 107 | lowercase k |
| l | 108 | lowercase l |
| m | 109 | lowercase m |
| n | 110 | lowercase n |
| o | 111 | lowercase o |
| p | 112 | lowercase p |
| q | 113 | lowercase q |
| r | 114 | lowercase r |
| s | 115 | lowercase s |
| t | 116 | lowercase t |
| u | 117 | lowercase u |
| v | 118 | lowercase v |
| w | 119 | lowercase w |
| x | 120 | lowercase x |
| y | 121 | lowercase y |
| z | 122 | lowercase z |
| { | 123 | left curly brace |
| | | 124 | vertical bar |
| } | 125 | right curly brace |
| ~ | 126 | tilde |
Национальные варианты ASCII
Стандарт ISO 646 (ECMA-6) предусматривает возможность размещения в ASCII национальных символов. Для этого предлагается заменять символы «@», «», «\», «», «^», «`», «{», «|», «}», «~». Также на месте знака решётки «#» может быть размещён символ фунта «£», а на месте символа доллара «$» — знак валюты «¤». Такая система хорошо подходит для европейских языков, так как в них используются символы латинского алфавита и лишь несколько дополнительных символов. Вариант ASCII, не содержащий национальных символов, называется «US-ASCII» или «international reference version».
Для некоторых языков (с нелатинской письменностью: русский, греческий, арабский, иврит и др.) существовали более радикальные модификации ASCII:
- В одной из таких модификаций — на месте строчных латинских букв размещались национальные символы (для русского и греческого — заглавные буквы).
- В другой модификации — предусматривалось переключение между US-ASCII и национальным вариантом; переключение осуществлялось «на лету»: с помощью символов «SO» (англ. shift out) и «SI» (англ. shift in); в этом случае — в национальном варианте можно было полностью заменить латинские буквы на национальные символы. См. также: КОИ-7.
Впоследствии оказалось удобнее использовать 8-битовые кодировки (кодовые страницы), в которых нижнюю половину кодовой таблицы (0—127) занимают символы US-ASCII, а верхнюю (128—255) — дополнительные символы, включая набор национальных символов. Таким образом, верхняя половина таблицы ASCII (до повсеместного внедрения Юникода) активно использовалась для представления локализированных символов, букв местного языка. Отсутствие единого стандарта размещения кириллических символов в таблице ASCII доставляло множество проблем с кодировками (КОИ-8, Windows-1251 и др.). Носители других языков с нелатинской письменностью тоже страдали, из-за наличия нескольких разных кодировок.
Первые 128 символов стандарта Юникод — совпадают с соответствующими символами US-ASCII.
| .1 | .2 | .3 | .4 | .5 | .6 | .7 | .8 | .9 | .A | .B | .C | .D | .E | .F | ||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| NUL | SOH | STX | ETX | EOT | ENQ | ACK | BEL | BS | HT | LF | VT | FF | CR | SO | SI | |
| 1. | DLE | DC1 | DC2 | DC3 | DC4 | NAK | SYN | ETB | CAN | EM | SUB | ESC | FS | GS | RS | US |
| 2. | ! | « | # | $ | % | & | ‘ | ( | ) | * | + | , | — | . | ||
| 3. | ; | < | = | > | ? | |||||||||||
| 4. | @ | A | B | C | D | E | F | G | H | I | J | K | L | M | N | O |
| 5. | P | Q | R | S | T | U | V | W | X | Y | Z | \ | ^ | _ | ||
| 6. | ` | a | b | c | d | e | f | g | h | i | j | k | l | m | n | o |
| 7. | p | q | r | s | t | u | v | w | x | y | z | { | | | } | ~ | DEL |
В первой версии стандарта ASCII (1963 год) — в позициях 0x5e (94) и 0x5f (95) располагались символы «стрелка вверх» и «стрелка влево», соответственно. Стандарт ECMA-6 (1965 год) заменил их на знак вставки и символ подчёркивание «_», соответственно.
В Советском Союзе стандарт был утвержден в виде таблицы международной ссылочной версии кода КОИ-7 Н0 ГОСТ 27463-87 (СТ СЭВ 356-86) «Системы обработки информации. 7-битные кодированные наборы символов».
Примеры[править]
Если записать строку ‘hello мир’ в файл exampleBOM, а затем сделать его hex-дамп, то можно убедиться в том, что разные символы кодируются разным количеством байт. Например, английские буквы,пробел, знаки препинания и пр. кодируются одним байтом, а русские буквы — двумя
Код на pythonправить
#!/usr/bin/env python
#coding:utf-8
import codecs
f = open('exampleBOM','w')
b = u'hello мир'
f.write(codecs.BOM_UTF8)
f.write(b.encode('utf-8'))
f.close()
hex-дамп файла exampleBOMправить
| Символ | BOM | h | e | l | l | o | Пробел | м | и | р | |||||
| Код в UNICODE | EF | BB | BF | 68 | 65 | 6C | 6C | 6F | 20 | D0 | BC | D0 | B8 | D1 | 80 |
| Код в UTF-8 | 11101111 | 10111011 | 10111111 | 01101000 | 01100101 | 01101100 | 01101100 | 01101111 | 00100000 | 11010000 | 10111100 | 11010000 | 10111000 | 11010001 | 10000000 |
История
Изначально (1963 год) ASCII была разработана для кодирования символов, коды которых помещались в 7 бит (128 символов; 27=128); при этом старший 7-й бит (нумерация с нуля) использовался для контроля ошибок, возникших при передаче данных. Со временем — кодировка была расширена до 256 символов (28=256); коды первых 128 символов не изменились. ASCII стала восприниматься как половина 8-битной кодировки, а «расширенной ASCII» называли ASCII с задействованным 8-м битом (например, КОИ-8).
Таблица ASCII определяет коды для символов:
- десятичных цифр;
- латинского алфавита;
- национального алфавита;
- знаков препинания;
- управляющих символов.
ISO/IEC 8859
Ранние кодировки были ограничены 7 битами из-за особенностей некоторых протоколов передачи данных. Однако со временем эти ограничения свою актуальность потеряли, в то время как необходимость в дополнительных символах для языков, использующих латинский алфавит, только росла. Поэтому в середине 80-х началась работа над группой 8-битных кодировок, получившей название ISO/IEC 8859. Все кодировки этой группы были основаны на ASCII. Помимо расширения диапазона доступных символов за счет восьмого бита, на печатные символы была заменена часть устаревших к тому моменту непечатных управляющих символов.
Здесь стоит отметить две кодировки из группы. Первая — ISO-8859-1 — была опубликована в 1987 году. Она включала в себя так называемый «Латинский алфавит номер 1» (сокращенно Latin-1), состоящий из 191 символа латинского письма. Этот набор символов используется по всей Северной и Южной Америке, в Западной Европе, Океании и на большей части Африки. Кодировка ISO-8859-1 стала основой для наиболее популярных 8-битных кодировок.
В 1988 году была опубликована ISO-8859-5. Она была создана для работы с кириллическими языками. Включенные в эту кодировку символы обеспечивали полную поддержку русского, белорусского, болгарского, сербского и македонского языков. А вот для полной поддержки украинского языка ей не хватало буквы «ґ». Особого распространения эта кодировка не получила, но интересен сам факт разработки кириллической кодировки в рамках группы кодировок ISO/IEC.