Рекурсивные алгоритмы на php. часть 1. основы рекурсии
Содержание:
Summary
Terms:
-
Recursion is a programming term that means calling a function from itself. Recursive functions can be used to solve tasks in elegant ways.
When a function calls itself, that’s called a recursion step. The basis of recursion is function arguments that make the task so simple that the function does not make further calls.
-
A recursively-defined data structure is a data structure that can be defined using itself.
For instance, the linked list can be defined as a data structure consisting of an object referencing a list (or null).
Trees like HTML elements tree or the department tree from this chapter are also naturally recursive: they branch and every branch can have other branches.
Recursive functions can be used to walk them as we’ve seen in the example.
Any recursive function can be rewritten into an iterative one. And that’s sometimes required to optimize stuff. But for many tasks a recursive solution is fast enough and easier to write and support.
Рекурсивные алгоритмы
Рекурсивные функции обычно решают проблему, сначала найдя решение для подмножеств проблемы (рекурсивно), а затем модифицируя это «подрешение», дабы добраться уже до верного решения. В вышеприведенном примере, алгоритм sumCount(value) сначала решает sumCount(value-1), а затем добавляет значение , чтобы найти решение для sumCount(value).
Во многих рекурсивных алгоритмах некоторые данные ввода производят предсказуемые данные вывода. Например, sumCount(1) имеет предсказуемый вывод (вы можете легко это вычислить и проверить самостоятельно). Случай, когда алгоритм при определенных данных ввода производит предсказуемые данные вывода, называется базовым случаем. Базовые случаи работают как условия для завершения выполнения алгоритма. Их часто можно идентифицировать, рассматривая результаты вывода для следующих значений ввода: , , «» или .
Суть рекурсии
В общем, рекурсивный подход подразумевает разделение сложной задачи, на один простой шаг к её решению и оставшуюся часть, которая становится упрощённой версией той же задачи. Затем этот процесс повторяется. Каждый раз вы совершаете один шаг, до тех пор, пока задача упростится до одного простейшего решения (его называют «базовым случаем»). Простейшее решение нашего базового случая с шагами, которые мы предприняли, чтобы добраться до него, образуют решение нашей первоначальной задачи.
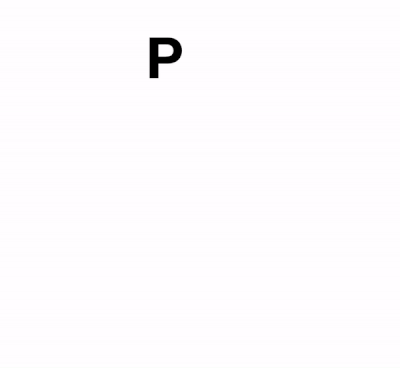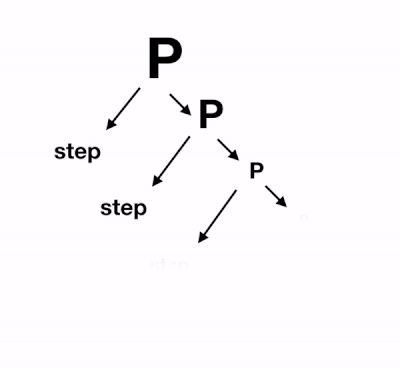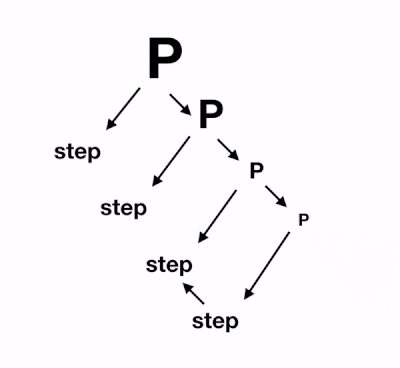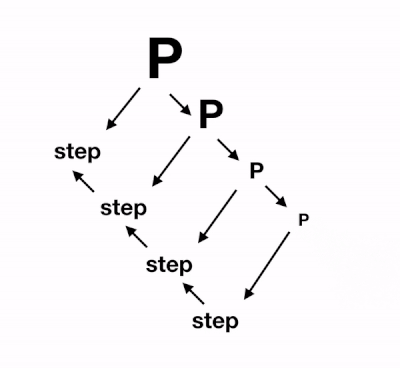
Мы каждый раз разделяем задачу «P» на шаги и оставшуюся упрощённую задачу той же формы, что и оригинал, пока не достигнем простого решения небольшой проблемы (базовый случай).
Предположим, у нас есть фактические данные определённого типа, назовём их dₒ. Идея рекурсии состоит в том, чтобы предположить, что мы уже решили задачу или вычислили желаемую функцию f для всех форм этого типа данных. Каждая из этих форм проще общей сложности dₒ, которую нам нужно определить. Следовательно, если мы можем найти способ выражения f(dₒ), исходя из одной или нескольких частей f(d), где все эти d проще, чем dₒ, значит мы нашли решение для f(dₒ). Мы повторяем этот процесс, и рассчитываем, что в какой-то момент оставшиеся f(d) станут настолько простыми, что мы сможем легко реализовать фиксированное, окончательное решение для них. В итоге, решением исходной задачи станет поэтапное решение более простых задач.
В приведённом выше примере (про написание статьи), данными является текст, содержащийся в документе, который я должен написать, а степень сложности — это длина документа. Это немного надуманный пример, но если предположить, что я уже решил задачу f(900) (написать 900 слов), то все, что мне нужно сделать, чтобы решить f(1000), ― это написать 100 слов и выполнить решение для 900 слов, f(900).
Давайте рассмотрим пример получше: с числами Фибоначчи, где 1-е число равно 0, второе равно 1, а nᵗʰ число равно сумме двух предыдущих. Предположим, у нас есть функция Фибоначчи, которая сообщает нам nᵗʰ число:
fib(n): if n == 0: return 0 if n == 1: return 1 else: return fib(n-1) + fib(n-2)
Как будет выглядеть выполнение такой функции? Возьмём для примера :
Визуализация древа рекурсии, показывающая рекурсивное вычисление, которое приводит к fib(4) = 3
Обратите внимание, что вычисление сначала выполняется в глубину
В процессе рекурсивного решения задачи полезно повторять мантру: «Притворяйся, пока это не станет правдой», то есть делай вид, что ты уже решил более простую часть задачи. Затем попытайся уменьшить большую часть задачи, чтобы использовать решение упрощённой части. Подходящая для рекурсии задача, на самом деле должна иметь небольшое количество простых частей, которые нужно решить явно. Другими словами, метод сокращения до более простой задачи может быть использован для решения любого другого случая. Это можно проиллюстрировать на примере чисел Фибоначчи, где для определения мы действуем, как будто мы уже рассчитали и В тоже время мы рассчитываем, что эти каскады и упрощения приведут к более простым случаям, пока мы не достигнем и , которые имеют фиксированные и простые решения.

«Притворяйся, пока это не станет правдой»
Рекурсивная стратегия
Рекурсивный подход — дело тонкое, и зависит от того, какую проблему вы пытаетесь решить. Тем не менее, есть некоторая общая стратегия, которая поможет вам двигаться в правильном направлении. Эта стратегия состоит из трёх шагов:
- Упорядочить данные
- Решить малую часть проблемы
- Решить большую часть проблемы
Как я уже говорил, я думаю, что для обучения полезно приводить пример, но помните, что рекурсивный подход зависит от конкретной задачи. Поэтому старайтесь сосредоточиться на общих принципах. Мы рассмотрим простой пример с реверсом строки. Мы напишем функцию которая будет работать так: . Я рекомендую вернуться назад и посмотреть, как эти шаги применяются к функции Фибоначчи, а затем попробовать применить их на других примерах (в интернете можно найти много упражнений).
В культуре
См. также: Mise en abyme и Эффект Дросте
Большая часть шуток о рекурсии касается бесконечной рекурсии, в которой нет условия выхода, например, известно высказывание: «чтобы понять рекурсию, нужно сначала понять рекурсию».
Весьма популярна шутка о рекурсии, напоминающая словарную статью:
Тема рекурсии присутствует во многих рассказах и очерках аргентинского писателя Хорхе Луиса Борхеса.
Несколько рассказов Станислава Лема посвящены (возможным) казусам при бесконечной рекурсии:
рассказ про Ийона Тихого «Путешествие четырнадцатое» из «Звёздных дневников Ийона Тихого», в котором герой последовательно переходит от статьи о сепульках к статье о сепуляции, оттуда к статье о сепулькариях, в которой снова стоит отсылка к статье «сепульки»:
Рекурсивный герб России
- Рассказ из «Кибериады» о разумной машине, которая обладала достаточным умом и ленью, чтобы для решения поставленной задачи построить себе подобную и поручить решение ей (итогом стала бесконечная рекурсия, когда каждая новая машина строила себе подобную и передавала задание ей).
- Рекурсивные акронимы: GNU (GNU Not Unix), PHP (PHP: Hypertext Preprocessor), WINE (Wine Is Not an Emulator) и т. д.
- Герб Российской Федерации является рекурсивно-определённым графическим объектом: в правой лапе изображённого на нём двуглавого орла зажат скипетр, который венчается уменьшенной копией герба. Так как на этом гербе в правой лапе орла также находится скипетр, получается бесконечная рекурсия.
- Рассказ Генри Каттнера «Порочный круг».
- Стихотворение детского поэта Андрея Усачева «Жучок»
- Стихотворение М. Ю. Лермонтова «Сон»
- Поисковая система Google при запросе «рекурсия» выводит надпись «Возможно, вы имели в виду: рекурсия»
Тест
Задание №1
Факториал целого числа N определяется как умножение всех чисел между 1 и N (0! = 1). Напишите рекурсивную функцию factorial(), которая возвращает факториал ввода. Протестируйте её с помощью первых 8 чисел.
Подсказка: Помните, что , поэтому умножение всех чисел между 1 и N — это то же самое, что и умножение всех чисел между N и 1.
Ответ №1
#include <iostream>
int factorial(int n)
{
if (n < 1)
return 1;
else
return factorial(n — 1) * n;
}
int main()
{
for (int count = 0; count < 8; ++count)
std::cout << factorial(count) << ‘\n’;
}
|
1 |
#include <iostream> intfactorial(intn) { if(n<1) return1; else returnfactorial(n-1)*n; } intmain() { for(intcount=;count<8;++count) std::cout<<factorial(count)<<‘\n’; } |
Задание №2
Напишите рекурсивную функцию, которая принимает целое число в качестве входных данных и возвращает сумму всех чисел этого значения (например, ). Протестируйте вашу программу, используя число (результатом должно быть ).
Ответ №2
#include <iostream>
int sumNumbers(int x)
{
if (x < 10)
return x;
else
return sumNumbers(x / 10) + x % 10;
}
int main()
{
std::cout << sumNumbers(83569) << std::endl;
}
|
1 |
#include <iostream> intsumNumbers(intx) { if(x<10) returnx; else returnsumNumbers(x10)+x%10; } intmain() { std::cout<<sumNumbers(83569)<<std::endl; } |
Задание №3
Это уже немного сложнее. Напишите программу, которая просит пользователя ввести целое число, а затем использует рекурсивную функцию для вывода бинарного представления этого числа (см. урок №44). Предполагается, что число, которое введет пользователь, является положительным.
Подсказка: Используя способ №1 для конвертации чисел из десятичной системы в двоичную, вам нужно будет выводить биты «снизу вверх» (т.е. в обратном порядке), для этого ваш стейтмент вывода должен находиться после вызова рекурсии.
Ответ №3
#include <iostream>
void printBinary(int x)
{
// Условие завершения
if (x == 0)
return;
// Рекурсия к следующему биту
printBinary(x / 2);
// Выводим остаток (в обратном порядке)
std::cout << x % 2;
}
int main()
{
int x;
std::cout << «Enter an integer: «;
std::cin >> x;
printBinary(x);
}
|
1 |
#include <iostream> voidprintBinary(intx) { // Условие завершения if(x==) return; // Рекурсия к следующему биту printBinary(x2); // Выводим остаток (в обратном порядке) std::cout<<x%2; } intmain() { intx; std::cout<<«Enter an integer: «; std::cin>>x; printBinary(x); } |
Задание №4
Используя программу из задания №3, обработайте случай, когда пользователь ввел или отрицательное число, например:
Подсказка: Вы можете конвертировать отрицательное целое число в положительное, используя для конвертации в unsigned int.
Ответ №4
#include <iostream>
void printBinaryDigits(unsigned int n)
{
// Условие завершения
if (n == 0)
return;
printBinaryDigits(n / 2);
std::cout << n % 2;
}
void printBinary(int n)
{
if (n == 0)
std::cout << ‘0’; // выводим «0», если n == 0
else
printBinaryDigits(static_cast<unsigned int>(n));
}
int main()
{
int x;
std::cout << «Enter an integer: «;
std::cin >> x;
printBinary(x);
}
|
1 |
#include <iostream> voidprintBinaryDigits(unsignedintn) { // Условие завершения if(n==) return; printBinaryDigits(n2); std::cout<<n%2; } voidprintBinary(intn) { if(n==) std::cout<<‘0’;// выводим «0», если n == 0 else printBinaryDigits(static_cast<unsignedint>(n)); } intmain() { intx; std::cout<<«Enter an integer: «; std::cin>>x; printBinary(x); } |
Упорядочивание данных
Этот шаг является ключевым для решения проблем рекурсивным способом, и все же его часто упускают из виду или выполняют неявно. Какие бы данные мы ни использовали, будь то числа, строки, списки, бинарные древа или люди, необходимо явно найти целесообразный порядок, который даст нам видение, как упростить задачу. Порядок полностью зависит от конкретной задачи, но для начала стоит подумать об очевидных вариантах. Например: числа можно упорядочить по величине, строки и списки можно упорядочить по длине, бинарные древа по глубине, а люди могут быть упорядочены бесконечным количеством разумных способов: рост, вес или должность в организации. Это упорядочивание должно соответствовать степени сложности задачи, которую мы пытаемся решить.

По порядку рассчитайсь, йехуу!
После того, как мы упорядочили данные, нам нужно подумать об этом, как о чём-то, что мы можем сократить. На самом деле, мы можем записать наш порядок в виде последовательности:
0, 1, 2, …, n для чисел (т.е. для int данных d, степень(d) = d)
[], , , …, для списков (len = 0, len = 1, …, len = n и т.д. для списка d, степень(d) = len(d))
Двигаясь справа налево, мы идём от общего («большая часть задачи») случая, к базовым («маленьким частям») случаям. В нашем примере с функцией мы работаем со строкой, и можем взять длину строки за основу, для упорядочивания или определения степени сложности задачи.
Рекурсивные структуры
Рекурсивная (рекурсивно определяемая) структура данных – это структура, которая повторяет саму себя в своих частях.
Мы только что видели это на примере структуры компании выше.
Отдел компании – это:
- Либо массив людей.
- Либо объект с отделами.
Для веб-разработчиков существуют гораздо более известные примеры: HTML- и XML-документы.
В HTML-документе HTML-тег может содержать:
- Фрагменты текста.
- HTML-комментарии.
- Другие HTML-теги (которые, в свою очередь, могут содержать фрагменты текста/комментарии или другие теги и т.д.).
Это снова рекурсивное определение.
Для лучшего понимания мы рассмотрим ещё одну рекурсивную структуру под названием «связанный список», которая в некоторых случаях может использоваться в качестве альтернативы массиву.
Представьте себе, что мы хотим хранить упорядоченный список объектов.
Естественным выбором будет массив:
…Но у массивов есть недостатки. Операции «удалить элемент» и «вставить элемент» являются дорогостоящими. Например, операция должна переиндексировать все элементы, чтобы освободить место для нового , и, если массив большой, на это потребуется время. То же самое с .
Единственные структурные изменения, не требующие массовой переиндексации – это изменения, которые выполняются с конца массива: . Таким образом, массив может быть довольно медленным для больших очередей, когда нам приходится работать с его началом.
Или же, если нам действительно нужны быстрые вставка/удаление, мы можем выбрать другую структуру данных, называемую связанный список.
Элемент связанного списка определяется рекурсивно как объект с:
- ,
- – свойство, ссылающееся на следующий элемент связанного списка или , если это последний элемент.
Пример:
Графическое представление списка:
Альтернативный код для создания:
Здесь мы можем ещё лучше увидеть, что есть несколько объектов, каждый из которых имеет и , указывающий на соседа. Переменная является первым объектом в цепочке, поэтому, следуя по указателям из неё, мы можем попасть в любой элемент.
Список можно легко разделить на несколько частей и впоследствии объединить обратно:
Для объединения:
И, конечно, мы можем вставить или удалить элементы из любого места.
Например, для добавления нового элемента нам нужно обновить первый элемент списка:
Чтобы удалить элемент из середины списка, нужно изменить значение предыдущего элемента:
перепрыгнуло с на значение . Значение теперь исключено из цепочки. Если оно не хранится где-нибудь ещё, оно будет автоматически удалено из памяти.
В отличие от массивов, нет перенумерации, элементы легко переставляются.
Естественно, списки не всегда лучше массивов. В противном случае все пользовались бы только списками.
Главным недостатком является то, что мы не можем легко получить доступ к элементу по его индексу. В простом массиве: является прямой ссылкой. Но в списке мы должны начать с первого элемента и перейти в N раз, чтобы получить N-й элемент.
…Но нам не всегда нужны такие операции. Например, нам может быть нужна очередь или даже двухсторонняя очередь – это упорядоченная структура, которая позволяет очень быстро добавлять/удалять элементы с обоих концов, но там не нужен доступ в середину.
Списки могут быть улучшены:
- Можно добавить свойство в дополнение к для ссылки на предыдущий элемент, чтобы легко двигаться по списку назад.
- Можно также добавить переменную , которая будет ссылаться на последний элемент списка (и обновлять её при добавлении/удалении элементов с конца).
- …Возможны другие изменения: главное, чтобы структура данных соответствовала нашим задачам с точки зрения производительности и удобства.
Two ways of thinking
For something simple to start with – let’s write a function that raises to a natural power of . In other words, multiplies by itself times.
There are two ways to implement it.
-
Iterative thinking: the loop:
-
Recursive thinking: simplify the task and call self:
Please note how the recursive variant is fundamentally different.
When is called, the execution splits into two branches:
- If , then everything is trivial. It is called the base of recursion, because it immediately produces the obvious result: equals .
- Otherwise, we can represent as . In maths, one would write . This is called a recursive step: we transform the task into a simpler action (multiplication by ) and a simpler call of the same task ( with lower ). Next steps simplify it further and further until reaches .
We can also say that recursively calls itself till .
For example, to calculate the recursive variant does these steps:
So, the recursion reduces a function call to a simpler one, and then – to even more simpler, and so on, until the result becomes obvious.
Recursion is usually shorter
A recursive solution is usually shorter than an iterative one.
Here we can rewrite the same using the conditional operator instead of to make more terse and still very readable:
The maximal number of nested calls (including the first one) is called recursion depth. In our case, it will be exactly .
The maximal recursion depth is limited by JavaScript engine. We can rely on it being 10000, some engines allow more, but 100000 is probably out of limit for the majority of them. There are automatic optimizations that help alleviate this (“tail calls optimizations”), but they are not yet supported everywhere and work only in simple cases.
That limits the application of recursion, but it still remains very wide. There are many tasks where recursive way of thinking gives simpler code, easier to maintain.
Контрольные примеры
Приведенные ниже контрольные примеры запускались в 64-разрядной среде исполнения IBM Java Runtime Environment (JRE) 7.0.4.0 (с аргументом командной строки -Xms256m -Xmx256m -Dcom.ibm.tools.attach.enable=no). Чтобы среда исполнения не тратила время на расширение и сжатие кучи, JRE запускалась с фиксированным размером кучи 256 МБ. Отключение API Attach не позволяет JRE запускать приложения-агенты (обычно используемые для мониторинга), что нормализует производительность в каждом тесте. При увеличении стека вызовов для инициализации стека и поддержания его на уровне 3 МБ использовался аргумент командной строки -Xss3m -Xssi3m.
Вычисление суммы
При суммировании чисел цикл показал значительно более высокую производительность, а концевая рекурсия оказалась быстрее головной. При увеличении стека вызовов Java до 3 МБ головная рекурсия сравнялась по скорости с концевой, но все же не смогла догнать цикл.
Рисунок 1. Рисунок 1. Вычисление суммы

Вычисление факториала
Этот примечательный пример иллюстрирует зависимость результатов от используемых операторов. При использовании простого типа данных int лучшие результаты во всех случаях получились для цикла. Применение типа int ограничивает величину результата до 32-разрядного целого числа со знаком. Для больших факториалов можно использовать тип данных BigInteger, но такая конструкция будет более затратной. Результаты применения BigInteger показали, что использование головной рекурсии в паре с концевой обеспечивает лучшее быстродействие, чем чисто концевая рекурсия или цикл.
Рекурсия в программировании
Допустим, нам нужно посчитать сумму всех чисел от 1 до какого-то числа. Можно это сделать в цикле, а можно сделать универсальную функцию с рекурсией. Ей будет достаточно указать на входе число, до которого нужно всё посчитать, а она сама сделает всё остальное.
Сначала запишем это на JavaScript, а потом разберёмся с тем, как работает эта магия:
Первая строчка — объявление функции function rec(x). Здесь всё как обычно — указываем название и говорим, что на вход будет поступать какая-то переменная, с которой можно работать.
Затем мы организуем нулевой уровень — тот, где рекурсия начинается: if (x == 1) {return(1)}. Он говорит нам: если на вход поступит единица, то возвращаем единицу. Это логично — сумма всех чисел от 1 до 1 равна единице. Это как дом, который построил Джек — всё в итоге сведётся к этому.
А дальше идёт самое интересное — если мы не дошли до единицы, то мы берём значение x и складываем его с результатом этой же функции, но от предыдущего значения. Если мы, например, считаем rec(10), то эта команда сделает так:
- Проверит, дошли ли до единицы.
- Если не дошли — сложит 10 и значение rec(9).
- Для этого она проверит, дошли ли до единицы.
- Если не дошли — сложит 9 и значение rec(8).
- Для этого она проверит…
- …
- Ура, мы дошли до единицы и возвращаем единицу обратно.
- К этому моменту рекурсия уже дошла до команды 2 + rec(1). Она получает в ответ единицу, складывает 2 и 1 и возвращает результат на уровень выше.
- На уровне выше была команда 3 + rec(2). Она получает в ответ 3, складывает 3 и 3 и возвращает результат на уровень выше.
- …
- На последнем уровне была команда 10 + rec(9). Она получает от предыдущего уровня результат 45, складывает 10 и 45 и получает результат 55.
- Ура, рекурсия закончилась.
Попробуйте сами вставить код в консоль и посмотрите на результат.
Области применения рекурсии
Рекурсия является очень мощным инструментом программирования. Ее можно использовать для решения задач, которые более эффективно представляются рекурсией и могут использовать стек вызовов. Как правило, это относится к задачам сортировки, которые эффективно решаются с помощью рекурсии, обеспечивающей более высокую скорость, чем циклы.
В задаче, получившей название Ханойская башня, даны три стрежня и диски разного размера, которые в исходном состоянии надеты на первый стержень в виде башни. Задача состоит в том, чтобы перенести башню на другой стержень, при этом запрещается класть большой диск на маленький. Эту замечательную задачу можно легко решить с помощью рекурсии за 2n — 1 ходов, где n — число дисков.
Например, возьмем четыре диска и попытаемся перенести их со стержня A на стержень C, используя стержень B для временного хранения. С помощью описанной ниже рекурсивной функции это может быть выполнено за 15 ходов. Процесс решения можно визуализировать этим апплетом. Функция вызывается (2n * 2) – 1, или 31 раз. Причина, по которой число вызовов функции не равно числу ходов, кроется в том, что для обработки ходов необходимо установить стек вызовов. В этом примере используется головная рекурсия (листинг 4).
Листинг 4. Листинг 4
private  static void solveTower(int num, int fromPeg, int toPeg,
			int tempPeg) {
 		if (num > 0) {
 			// move a disc from the fromPeg to the tempPeg
			solveTower(num - 1, fromPeg, tempPeg, toPeg);

 			System.out.println("Disc moved from " + fromPeg + " to " + toPeg);

 			// move disc from the tempPeg to the toPeg
			solveTower(num - 1, tempPeg, toPeg, fromPeg);
		}
	}
Результат для четырех дисков показан в листинге 5.
Листинг 5. Листинг 5
1. Диск перенесен с 1 на 2
2. Диск перенесен с 1 на 3
3. Диск перенесен с 2 на 3
4. Диск перенесен с 1 на 2
5. Диск перенесен с 3 на 1
6. Диск перенесен с 3 на 2
7. Диск перенесен с 1 на 2
8. Диск перенесен с 1 на 3
9. Диск перенесен с 2 на 3
10. Диск перенесен с 2 на 1
11. Диск перенесен с 3 на 1
12. Диск перенесен с 2 на 3
13. Диск перенесен с 1 на 2
14. Диск перенесен с 1 на 3
15. Диск перенесен с 2 на 3
Ханойская башня — широко распространённая задача, которую можно решить с помощью рекурсии. Однако не все задачи столь очевидны, многие из них требуют времени на анализ и решение. Ханойскую башню можно решить и с помощью циклов, однако это потребует использования нескольких различных циклов и итераторов. Это решение будет работать дольше и потребует большего объема кода.
Ниже показан итерационный способ решения Ханойской башни. В этом примере использованы операции с битами, которые работают быстрей математических операций. За основу была взята эта программа на языке C.
Листинг 6. Листинг 6
int  numMoves = (1 << numDiscs) - 1;
int [] pegs = { 1, 2, 3, 1, 3, 2 };
int  count = 0;

for  (int currMove=1; currMove <= numMoves; currMove++) {
	int disc = 0;
 	while ( (currMove >> disc & 1) == 0 ) {
		disc++;
	}
 	int level=(numDiscs - disc) & 1;
 	int fromPeg =(currMove >> ++disc) % 3;
	fromPeg = pegs;
 	int toPeg =(fromPeg + level) % 3 + 1 ;
 	System.out.println (++count + ". Disc moved from " + fromPeg  + " to " + toPeg) ;
}
Итого
Термины:
-
Рекурсия – это термин в программировании, означающий вызов функцией самой себя. Рекурсивные функции могут быть использованы для элегантного решения определённых задач.
Когда функция вызывает саму себя, это называется шагом рекурсии. База рекурсии – это такие аргументы функции, которые делают задачу настолько простой, что решение не требует дальнейших вложенных вызовов.
-
Рекурсивно определяемая структура данных – это структура данных, которая может быть определена с использованием самой себя.
Например, связанный список может быть определён как структура данных, состоящая из объекта, содержащего ссылку на список (или null).
Деревья, такие как дерево HTML-элементов или дерево отделов из этой главы, также являются рекурсивными: они разветвляются, и каждая ветвь может содержать другие ветви.
Как мы видели в примере , рекурсивные функции могут быть использованы для прохода по ним.
Любая рекурсивная функция может быть переписана в итеративную. И это иногда требуется для оптимизации работы. Но для многих задач рекурсивное решение достаточно быстрое и простое в написании и поддержке.