Как правильно составить семантическое ядро
Содержание:
- Составляем семантическое ядро своими руками
- А нужно ли вообще составлять семантику?
- Бесплатное составление семантического ядра
- Rush Analytics
- Какие еще источники используем
- Сколько времени занимает сбор семантического ядра
- Подключаем инструменты подбора семантики
- Системы аналитики
- Группы ключевых слов
- Анализ поисковой выдачи
- Этапы сбора семантического ядра для сайта и контекстной рекламы
- Картинки (изображения) на сайте
- Этап 1. Сбор вариаций написания продукта и маркеров
Составляем семантическое ядро своими руками
Подберите вышеуказанными способами подходящие ключевые запросы. Не стоит сразу набирать 2000, можно ограничиться 200 запросами, а потом развивать. Посидите и подумайте, какие ключи можно использовать и составьте полный список. Вам нужно набрать ключи для первой страницы и еще для нескольких статей.
Отсейте слова и запросы, по которым вы не планируете продвигаться. У меня часто попадаются запросы вроде «работа на дому Пермь» или по другим городам, так что их сразу выкидываю. Оценивайте сразу – что хотят получить люди по этому запросу и сможете ли вы это дать?
Убирайте высококонкурентные запросы, по которым вы не сможете пробиться в ТОП10. При возникновении сомнений посмотрите на сайте Мутаген уровень конкуренции. Ну или вручную оценивайте выдачу – популярные запросы видно сразу.
Распределите запросы по сайту. Среднечастотные запросы идут на главную страницу, низкочастотные сгруппируйте по смыслу и используйте в статьях или разделах. Используйте их как ключевые слова в статьях (1 среднечастотный главный, пара низкочастотных в статье и подзаголовках, и разбавьте по тексту вспомогательными). Вписывайте в среднем 1-2 ключа на 2000 знаков, не чаще.
Некоторые не создают СЯ и все равно добиваются успеха. Но лучше знать, как составить семантическое ядро своими руками, программы для подбора слов сделают это практически на автомате (словоеб). А вам будет потом намного проще развиваться и писать статьи.
А нужно ли вообще составлять семантику?
Так как грамотный подход требует много личного времени, а если отдать это дело на исполнение фрилансеру вы потратите немало денег, то ответ будет неоднозначный, как может показаться на первый взгляд. Но спешу вас переубедить на личном опыте, что оно того стоит!
Если вы планируете создать свой авторский блог и сами будете наполнять его полезным контентом, то со временем ваш энтузиазм иссякнет, и погаснет та звездочка о заработки в интернете. Потому что, на раскрутку своего ресурса потребуется не менее года, а то и больше и это при условии постоянной, ежедневной работы над сайтом.
А вот семантическое ядро вас будет здорово подстегивать писать новые статьи, так как у вас всегда будет новая тема для ведения записей. Статьи будут продвигаться в ТОПы, начнут приходить все новые и новые посетители. Прибыль с каждой новой статьей будет идти только вверх. И это здорово мотивирует, хочу вам сказать!
Без этого вообще сегодня никуда
Правильно найденные и структурированные запросы помогут не только грамотно прописывать мета-теги, но и вести контекстную и другие виды рекламы, что так важно для сетевого бизнеса
Поэтому, дамы и господа, начинайте заниматься сбором сем ядра! А далее я вам покажу как можно сделать это совершенно бесплатно, используя несколько программ и немного поработать с файлами в формате excel.
Бесплатное составление семантического ядра
Как составить семантическое ядро? Существует несколько бесплатных способов. Возможно, для некоторых ничего нового не будет, но все систематизирую в одном месте .
2. Яндекс Wordstat
Классика жанра . Многие пользуются только им. В принципе поисковая система Яндекс занимает что-то около 60% рынка, поэтому данные ВордСтата, несмотря на то, что не на 100% точные (полезная статья «Мифы о WordStat»), дают лучшую картину для составления семантического ядра. Все просто: задаете тему и получаете список поисковых запросов.
Причем полезным будет не только первый столбик, но и второй. Также необходимо помнить про операторы «» (кавычки) и ! (восклицательный знак). А поможет в автоматизации отличная программа для составления семантического ядра — СловоЕб. Она парсит Wordstat, уточняет частотность в кавычках и с восклицательным знаком, определяет сезонность, а также находит релевантные страницы для сайта в выдаче Яндекса и Google. Полезная программа, которая еще и бесплатна . Еще не забывайте про регион, если у вас региональный сайт и геозависимые запросы (в программе это также можно уточнять).
Все данные со Словоеба легко экспортируется в CSV-файл, который можно открыть в Excel.
3. Google External Keyword Tool
Так раньше назывался отдельный сервис. Теперь он интегрирован в аккаунт Google Adwords. Но суть осталась та же. Это сервис по подбору ключевых слов для контекстных рекламных кампаний в среде Google. Но он также подойдет и в поисковой оптимизации для составления семантического ядра запросов.
Как видите данных существенно меньше, чем в wordstat. Можно задавать широкое, точное и фразовое соответствия, а также видеть информацию по конкуренции, цене за клик, динамике запросов. Если вы хотите максимально полностью охватить нишу, то дополнительно можно воспользоваться и Google External Keyword Tool. Редко, но попадаются уникальные запросы, которые не видны в вордстате. В данном случае «создать семантическое ядро».
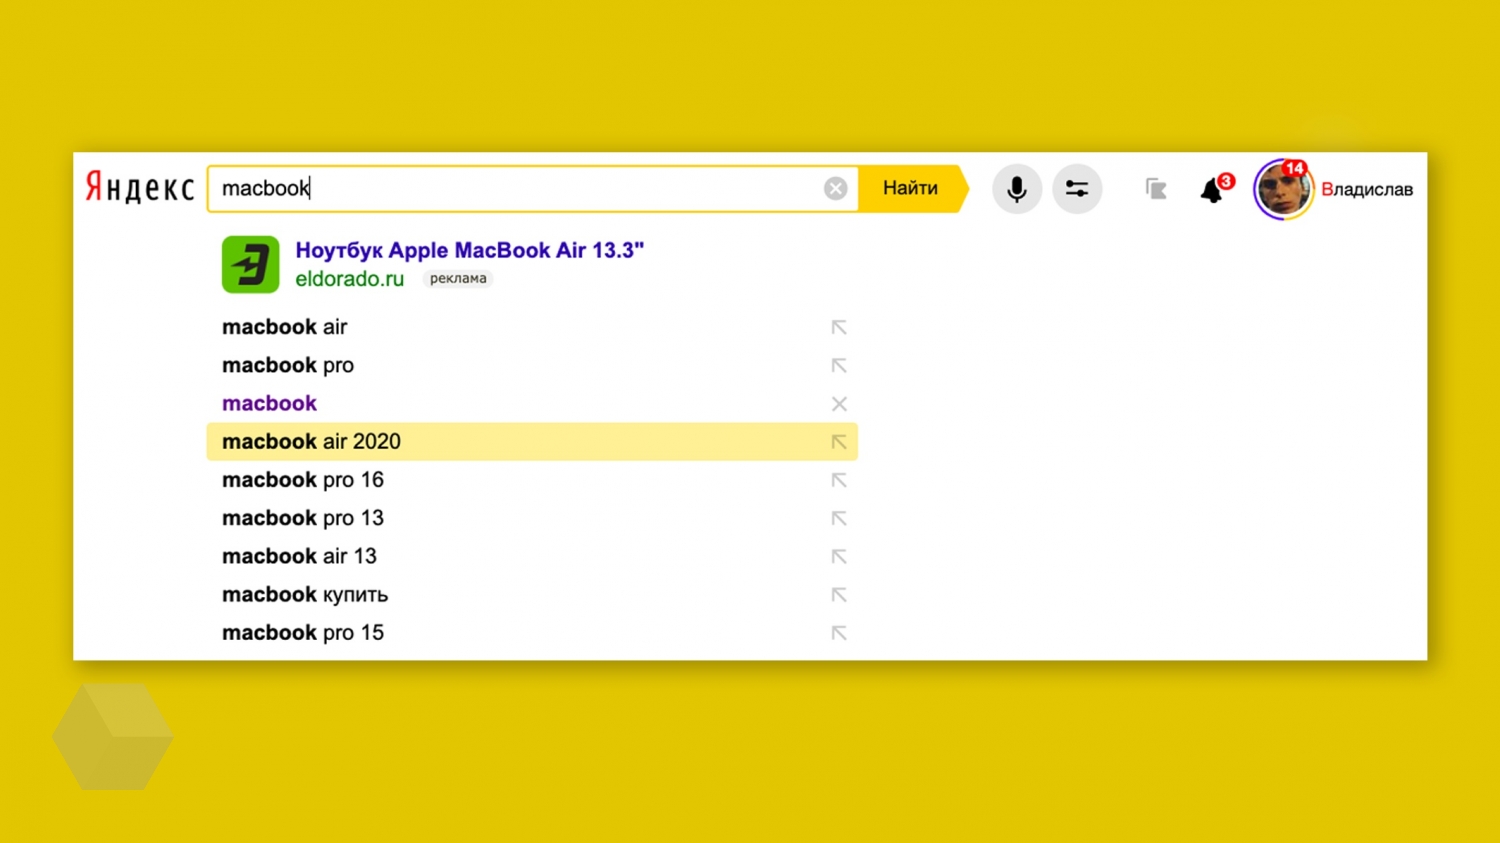
4. Поисковые подсказки
Подбор и анализ семантического ядра можно осуществлять и с помощью поисковых подсказок. Можно вбивать и составлять вручную.
А можно воспользоваться бесплатной программой для парсинга поисковых подсказок с поисковиков: Яндекс, Google, Рамблер, Mail, Yahoo, Nigma. Называется она Словодер. Скачать и пользоваться ее можно бесплатно.
Поисковые подсказки хороши тем, что в основном они появляются, потому что задаются реальными пользователями, поэтому по ним должен быть трафик, то есть это не, так называемые, «пустышки».
5. Анализ семантического ядра конкурентов
Можно не самому «протаптывать дорогу», а понаблюдать за конкурентами. Анализирую запрос «семантическое ядро» по Яндексу. Нахожу на 4-ом месте сайт с открытой статистикой liveinternet. Захожу в «по поисковым запросам» + «за месяц». Дополнительно делаю фильтр-срез «семант», чтобы увидеть по каким интересующим ключевым фразам заходили на сайт с поисковиков. Получаю следующую картину.
Этот метод хорош тем, что получается картина по реальным заходам посетителей на сайт. Также можно прикинуть, сколько посещений можно получить при нахождении на определенной строчке выдаче по искомому ключевому слову.
Общая схема составления семантического ядра
- Сбор всевозможных ключевых слов и поисковых запросов по необходимой теме, нише, категории и так далее.
- Удаление тех запросов, которые не подходят вам + удаление дублей.
- Определение частотности и потенциального трафика. Удаление «пустышек» и ключевых слов, которые имеют низкий потенциал по посетителям.
- Определение конкуренции и удаление запросов с высоким для вас показателем.
Удаление неподходящих слов можно производить на каждом этапе, чтобы с каждым новым пунктом работать с меньшим массивом данных. В итоге у вас должен получиться список ключевых слов, которые интересны вам, обладают неплохим потенциалом по трафику и имеют умеренную для вас конкуренцию.
2 небольшие новости. Сегодня обновление тематического индекса цитирования. На блоге +65. Теперь его значение 275. На остальных сайтах практически все на месте. Как у вас дела с этим показателем?
Вчера заметил, что Яндекс присвоил блогу быстрые ссылки. В поисковой выдаче это выглядит так.
В панели вебмастера другая картина.
Я уже подредактировал быстрые ссылки. Теперь жду обновления и небольшого увеличения CTR в выдаче. На сегодня все. Жду ваши комментарии .
Rush Analytics
Это платный сервис, включающий бесплатный триал на 14 дней, который автоматизирует задачи при парсинге семантического ядра, а именно:
- Проверяет позиции в Яндекс и Google;
- Выполняет кластеризацию запросов;
- Собирает ключевые слова на основе поисковых подсказок;
- Собирает данные из Яндекс.Wordstat в облаке;
- Проверяет индексацию URL;
- Анализирует текст и другие зоны страниц.
С помощью Rush Analytics можно удобно и быстро собрать ключевые слова из Яндекс Wordstat (левой и правой колонок) и Google Рекламы, а также поисковые подсказки.
Всё просто: вы задаете свой запрос, по которому хотите найти похожие, и получаете результаты, вместе с данными по частотности. Без риска «схватить» капчу.
Всё начинаете с создания задачи.

Далее по порядку задаете регион и настройки сбора семантики.
Вы можете собирать ключи из левой и правой колонок или с данными по частотности. Укажите, сколько страниц выдачи Вордстата использовать для сбора запросов. Естественно, чем больше страниц – тем больше результатов.

Если вы выбираете вариант «Сбор частотности», вы можете указать, какой тип частотности вам нужен.

Далее загрузите запросы списком или в виде файла в xls / xlsx.

Также в Rush Analytics есть возможность почистить семантику от стоп-слов – для этого сервис предлагает готовые списки стоп-слов по тематикам.
Когда всё готово, отслеживайте процесс сбора на странице задач.
Какие еще источники используем
Парсинг конкурентов
Но важно, чтобы конкуренты были с вами в «одном весе». Если вы продаете картриджи для принтеров не стоит сравнивать себя с маркетплейсом или условным «Эльдорадо»
Конкурент должен заниматься примерно тем же и обладать схожим ассортиментом.

Полезные инструменты для SEO-специалиста
В анализе конкурентов идем дальше и вычисляем фрагмент семантики, общий у нескольких конкурирующих с вами сайтов — для нас это маркер, что необходимо проработать этот фрагмент запросов.

Сравнивая семантические ядра конкурентов, анализируем сегменты, не пересекающиеся с нашим
Под процессом сбора подразумеваем не только формирование списка фраз, но и сбор информации по ним. Для этого вычищаем семантику от нулевок, нерелеванта, информационных запросов и дублей. Получаем большую выборку ключей, которые пока никак не проранжированы, в ключах нет дополнительной информации и мы пока не можем определить какие фразы хорошие, а какие нет. Поэтому прогоняем фразы по дополнительным параметрам.
|
На один и тот же запрос поисковые системы дают разные релевантные страницы — это плохой сигнал, страницы конкурируют по этому запросу. Специалисту тогда придется руками проверять и назначать ту страницу, которую будем оптимизировать. Так, мы избегаем «каннибализации запросов» — когда несколько страниц внутри проекта борются за одну и ту же фразу. |
Сколько времени занимает сбор семантического ядра
Ответ на этот вопрос является строго индивидуальным и зависит от множества факторов: тематика, регион, размер и тип сайта, цель сбора.
Приведенные ниже данные являются статистическими и основаны исключительно на полученном нашими оптимизаторами опыте.
Подбор одной группы запросов занимает от 1 до 5 часов. На выходе получаем в среднем 50-200 запросов.
Примеры из нашей практики:
Сбор первоначальной семантики для небольшого коммерческого регионального сайта занимает от 2 до 8 часов. На выходе получаем в среднем 50-300 запросов.
Примеры из нашей практики:
Так мы делаем довольно редко, поскольку подобные временные затраты на первых этапах работы с проектом просто не целесообразны.
Если речь идет о крупных статейных ресурсах, то тут сроки варьируются от 10 до 40 часов. Для информационных ресурсов мы тоже рекомендуем производить сбор по группам для рационального распределения времени.
Подключаем инструменты подбора семантики
Когда идеи закончатся, время прибегнуть к помощи инструментов, ведь довериться интуиции недостаточно — инструменты по подбору помогут сосредоточиться на фактических запросах пользователей.
На этом этапе нужно не просто расширить список ключевых фраз, но и отсеять ненужные ключевые слова. Сделать это можно с помощью инструмента подбора ключевых слов Wordstat Яндекса. Чем полезен именно этот инструмент? Он показывает только реальные запросы пользователей, и это поможет собрать актуальные ключевые слова для нужной тематики.
Работать с сервисом просто: задаем регион, в окошко вводим первичный запрос и видим, сколько раз за последние 30 дней пользователи Яндекса вводили поисковой запрос, содержащий искомые слова.
 Пример работы с Яндекс Wordstat
Таким образом, используя базовые ключевые слова из вашей сферы, можно получить подробный список запросов с нужным словом, а также другие фразы, которые еще искали люди с этим словом.
В левой колонке Яндекс показывает основные запросы, в правой — вспомогательные (ассоциативные). Нам нужны и те, и другие.
Из всех найденных вариантов отбираем только те запросы, которые соответствуют нашему предложению — они и будут ключевыми словами семантического ядра. А также определяем слова или фразы, которые стоит добавить в список минус-слов — по ним реклама показываться не будет. Это позволит избежать расхода бюджета на нецелевые переходы и сохранить высокую кликабельность объявлений.
Основная цель использования минус-слова заключается в том, чтобы отключить показы рекламных объявлений по запросам, не связанным с вашим товаром или услугой. К примеру, у сервиса по доставке цветов нет бесплатного оказания услуги, поэтому фразы, включающие слово «бесплатно», будут для нас нецелевыми запросами. Занесем слово «бесплатно» в список минус-слов.
 Пример нецелевых запросов в Wordstat Яндекс
Попробуем сделать это в Wordstat и увидим изменение количества показов:
 Изменение числа показов в Wordstat при минусовании запросов
Разница в числе показов — это та часть нецелевой аудитории, которую удалось отсечь. В будущем это поможет избежать нерациональной траты рекламного бюджета.
Системы аналитики
С помощью собственных систем аналитики поисковиков можно найти запросы, по которым пользователи заходили на сайт и как страницы ранжируются по этим запросам.
Данный способ составления семантики больше подходит для уже созданного блога. С их помощью можно, определить соответствие запроса статье. Если статья не входит в ТОП-100 по этому запросу, то есть смысл ее переписать, применив в тексте релевантный ключ, который выдает система.
В интернете есть сайты, у которых открыты счетчики статистики. Т.е. вы спокойно заходите на ресурс конкурента, ищите иконку счетчика и кликнув по ней попадаете в статистику, которая покажет вам по каким запросам продвигается сайт. Если он ранжируется достаточно высоко, то можно смело брать все фразы в оборот и писать под них статьи.
Но, к сожалению, таких ресурсов очень мало и найти их бывает достаточно сложно. Но это тоже один из способов сбора ключевых запросов, который имеет место на существование.
Если вам повезет, то поверьте, семантическое ядро вашего блога будет собрано на 70-90%, за короткий промежуток времени и без лишних телодвижений.
Далее я коротко расскажу про основные системы аналитики, которыми пользуюсь.
Яндекс.Метрика
Показывает статистику переходов и поисковых ключевых запросов из Яндекса
Что важно знать при сборе семантики из данной системы?

В открывшемся окне представлено достаточно много панелей:
- Различные панели посетителей;
- Источники трафика;
- Показатели отказов ;
- Глубина просмотра страниц;
- Время, проведенное пользователем на блоге;
- Примерный возраст посетителя
- И многое другое.
Переходим в левую колонку «Меню» — «Отчеты» — «Поисковые запросы». Внизу найдем список из того, что нам нужно.

Также здесь будет полезным посмотреть количество визитов и отказов, глубину просмотра и время пребывания пользователя на сайте.
Переносим все ключи в свою таблицу и далее работаем с ней.
Google Analytics
Гугл не покажет вам в «чистом» виде запросы пользователей. Однако, посмотрев на блок «Какие страницы просматривают пользователи» в панели аналитики, можно получить страницы сайта, перейдя и проанализировав которые, можно легко вычислить ключ продвигаемой странички.
Надо учитывать, что данная ПС будет выдавать результат только своего робота, запросы из других поисковых систем Google не показывает.
LiveInternet
Эта система аналитики также может помочь в подборе «вкусных» ключей для дальнейшего продвижения. Статистика именно этого сервиса бывает открыта для постороннего глаза. И этой «лазейкой» обязательно надо пользоваться.
- справа — основная панель управления;
- по центру — отчет по посещаемости и график статистики.
Инструментов аналитики очень много. Нас же интересуют только две:
- позиции в Яндексе;
- позиции в Google.

Они пока находятся в тестовом режиме, но все равно, кое-какую информацию по ключам можно получить уже сейчас.
Группы ключевых слов
Все ключевые слова семантического ядра можно разделить на группы. Классифицировать можно по частотности, геозависимости и коммерческим показателям. Давайте рассмотрим каждый вариант.
Частота ключевых слов
Частотностью ключевых слов называют количество поисковых запросов, связанных с каким-то конкретным ключом. Этот фактор определяет как много людей (и как часто) ищут что-то, используя те или иные словосочетания. Различают следующие кластеры:
- Высокочастотные запросы (ВЧ) – наиболее популярные ключевые слова в поисковых системах.
- Среднечастотные (СЧ) – менее популярные ключевики. Что-то вроде золотой середины.
- Низкочастотные (НЧ) – ключевые слова, с которыми обращаются в поисковик не так уж часто.
- Микронизкочастотные (МНЧ) – когда запросов почти нет, раз-два и обчелся.

Продвижение по каждому из кластеров может сильно отличаться. Причем не только по сложности. Если вы хотите узнать, как отличить ВЧ запрос от СЧ, или наоборот, то я предлагаю вам присмотреться к одному из самых распространенных вариантов в Рунете:
- ВЧ – от 10 000 запросов в месяц;
- СЧ – от 1 000 до 10 000;
- НЧ – от 100 до 1 000;
- МНЧ – менее 100.
Не могу утверждать, что это абсолютная истина. Многие SEO-специалисты устанавливают свои собственные референсы, исходя из личного опыта. Какому варианту верить – решайте сами. Однако должен уточнить, что эти цифры могут значительно меняться как в большую, так и в меньшую сторону. Особенно если мы говорим о продвижении по региональным запросам.

Коммерция
Помимо частотности ключевых слов, их можно разделить еще и на коммерческие и некоммерческие. Первые, понятное дело, представляют собой запросы, которые используются пользователями для поиска товаров или услуг с целью их дальнейшего приобретения. Вторые же, как правило, используются для поиска информации.
В свою очередь, запрос “Как установить Windows на ПК” можно отнести к некоммерческому запросу, т. к. человек просто ищет информацию по установке или эксплуатации своей машины.
Благодаря этому повышается конверсия (количество пользователей, выполнивших целевое действие, т. е. купивших товар или услугу), что в свою очередь повышает доходность проекта.
Геолокация
Местоположение человека, который осуществляет поиск в Яндексе или Гугле, тоже может быть очень важным фактором. К примеру, по запросу “Лучшие клубы города” жителям Москвы и Иваново будут показаны совершенно разные результаты. Это называется геозависимость запросов, когда таргетинг идет именно на расположение хоста (пользователя).
Если региональность вам действительно важна, то составлять СЯ стоит с учетом расположения, т. е. геолокации.
Как вы могли догадаться, по геолокации запросы могут делиться на зависимые и независимые.
Но вот по геонезависимым запросам можно действительно неплохо повысить конверсию. Например, если в дополнение к вашему магазину на проекте есть еще и информационный блог, где находятся полезные материалы по покупке тех или иных видов товаров, то пользователи, переходящие к вам с общих, независимых от геолокации ключевиков, смогут улучшить поведенческие факторы вашего сайта. Что в конечном итоге продвинет его выше, как по нужному региону, так и в целом.
Я думаю, что принцип работы региональности в поисковых системах не должен вызывать затруднений. Подытожив, можно сказать, что геолокация хоста может очень сильно влиять на выдачу
И если ваш сайт заточен под какой-то конкретный регион или группу регионов, то вам определенно стоит обратить внимание на этот фактор при составлении семантического ядра
Анализ поисковой выдачи
Теперь Rank Tracker при отслеживании позиций Вашего сайта будет собирать данные по позициям всех сайтов в поисковой выдаче (SERP) вплоть до 30-й позиции а также . В настройках программы в разделе Режим проверки позиций (рисунок ниже) можно отключить запись истории поисковой выдачи (SERP), без этого невозможно её анализировать.

Rank Tracker
Данные можно найти в разделе Проверка позиций – SERP Analysis (рисунок ниже).

Анализ поисковой выдачи
Отслеживание позиций сайта
Функция доступна Rank Tracker Professional и Enterprise. Прямо в таблице Вы сможете видеть не только домен, но и полный URL-адрес страницы конкурента, скопировать его или экспортировать данные в CSV. Плюс, можно с лёгкостью добавить нужный домен в раздел . В этой же таблице (рисунок ниже) будут отмечены цветом те конкуренты, которых Вы отслеживали ранее (их адреса должны быть добавлены в настройках проекта в Конкуренты). Тут же будут видны данные по универсальной выдаче (картинки и т.д.).

Таблица конкурентов
Новый инструмент даёт возможность понимать общую картину изменений по позициям в Вашей нише, причём не только по прямым конкурентам, а и по всему топ-30.
Этапы сбора семантического ядра для сайта и контекстной рекламы
Сбор семантического ядра – начальная и очень важная ступень, которую следует пройти перед продвижением любого интернет-ресурса. При этом не имеет значения, разрабатываете вы маркетинговую кампанию в контекстной рекламе или намереваетесь продвигать свой ресурс в поисковиках при помощи естественных ссылок. Уже на первой ступени нужно понимать, как потенциальные покупатели будут искать ваш продукт в Интернете.
Этап 1. Подбор основных ключей
На этой стадии необходимо самостоятельно продумать очень много запросов. Рекомендуем сесть и провести мозговой штурм: прикинуть, по каким запросам будет проходить основная тема.
Например, сайт kakzarabativat создает материалы по темам: «Финансы и инвестиции», «Собственный бизнес», «Маркетинг и правовые аспекты бизнеса». Соответственно, сначала необходимо будет собрать приблизительно такие ключи: «свой бизнес», «собственный бизнес», «инвестиции», «финансы», «маркетинг». И уже, отталкиваясь от них, расширять основное семантическое ядро.
Так же обстоят дела с бизнесом – только несколько проще. Вам нужно просто выписать все ключи, которые относятся к вашему бизнес-направлению или сайту. Если специализируетесь на продаже туров, выпишите: «путевки», «туры», «купить тур» и т. д. Все возникающие идеи ассоциируйте со своей деятельностью. Подобранные слова и будут главными ключами.
Рекомендуемые статьи по данной теме:
- Практические советы по раскрутке сайта
- Анализ контента сайта: 9 этапов + сервисы помощники
- Все, что вы хотели знать про услуги продвижения сайта
Этап 2. Расширение семантического ядра
После сбора основных ключей, которые будут использованы на сайте, начинайте расширять семантическое ядро. На этом этапе у многих возникают сложности. Для решения этой задачи вы можете использовать специальные программы, о которых мы расскажем далее.
Запишите основные запросы в программу и вы получите множество вариантов того слова, которое искали пользователи. Сформируется огромная база ключевых слов, относящихся к вашей тематике. Это и будет расширением семантического ядра.
Расширять семантическое ядро можно неограниченное количество раз, особенно на информационных площадках. Появилась новая рубрика? Соберите по ней запросы, отфильтруйте их, расширьте или адаптируйте под каждую тему.
Этап 3. Отсев лишнего
После сбора и расширения семантического ядра отсейте, в том числе вручную, «мусор», то есть ключи, которые не будете использовать.

Проверьте весь список ключей, выданных программой, и уберите:
- любые упоминания о конкурентах;
- ключевые запросы с информацией, которую вы не будете освещать;
- ключи, убивающие поведенческие факторы: как правило, «дешево» и все производные словоформы (для бизнеса);
- смысловые повторы ключей;
- фразы с ошибками и опечатками;
- ключи с привязкой к региону, если вы не относитесь к этой территории (для бизнеса).
Отсеивать все это нужно будет вручную сразу после выгрузки всех ключей. Убрав лишнее, можете начинать группировать ключи по конкретным тематикам и расширять определенные тематические направления для материалов. Все! Вы создали правильное семантическое ядро сайта.
Не пытаетесь собрать семантическое ядро стопроцентно автоматически. Так или иначе придется вручную отсеивать мусор, устраняя похожие ключи. Не полагайтесь на программы полностью.
Картинки (изображения) на сайте
Для лучшей подачи материала, наглядности, на сайте используются изображения. Освоить онлайн сервисы и десктопные программы создания и редактирования картинок ещё не удалось, поэтому использую два способа.
Joxi – программа для скриншотов
В основном делаю скриншоты с экрана компьютера. Во-первых – это достоверная информация. Из первых рук, так сказать. Во-вторых – картинка уникальная.
Смотрите видео по работе программы.
Photoshop – графический редактор
Когда беру изображение из общего доступа, из сети, немного редактирую его. Сильно не заморачиваюсь: разверну на небольшой угол, изменю оттенок. Еще в Фотошопе делаю надпись с адресом сайта в углу.
Уникальность изображения
После манипуляций в фотошопе следует проверка картинки на уникальность. Для этого использую замечательный онлайн сервис Tineye. Анализ картинки на уникальность проходит в течении нескольких секунд. Загрузить картинку можно как с компьютера, таки прописав адрес в интернете.

Оптимизация изображений для сайта
Одним из факторов ранжирования сайта в поиске является скорость загрузки у пользователя. Публиковать картинки без уменьшения веса нельзя. Ранее для сжатия картинок использовал Photoshop. Но как-то после проверки скорости загрузки сайта в PageSpeed Insights от Гугл увидел много замечаний именно по объему изображений. Провёл тест нескольких онлайн сервисов как сжать картинки и выбрал для себя ILoveIMG.
Этап 1. Сбор вариаций написания продукта и маркеров
Перед сбором запросов необходимо выявить все возможные варианты написания продвигаемого продукта, а также маркеры (свойства). Для этого мы используем сервис подбора слов Яндекса.
Методика
Вписываем название нашего продукта в поисковую строку и нажимаем кнопку «Подобрать».

Детально просматриваем запросы из правой колонки полученных результатов и выявляем синонимы или иные варианты нашего запроса.

Переносим все найденные варианты названия продукта в отдельный файл.

На следующем шаге следует собрать маркеры, то есть свойства, определяющие продукт. Данные маркеры можно объединить по типам схожих свойств, например, Цвет, Бренд, Тип и иных.
Для выявления маркеров есть два пути:
1.Сбор и последующая чистка всей семантики по названию продукта, например, «Мотошлем».
1.1. Плюс: Сбор всех существующих в спросе маркеров;
1.2. Минус: Долгий и трудозатратный процесс.
2. Поиск и анализ страниц конкурентов в ТОП 10, которые уже имеют страницы с нашим продуктом.
2.1. Плюс: Быстрый процесс;
2.2. Минус: Неполный сбор свойств, если они отсутствуют у конкурентов.
Используя второй вариант, находим сайты конкурентов по запросам названия продукта, взяв страницы из ТОП 10
Это возможно сделать вводом основного запроса прямо в поисковую систему или же воспользоваться инструментом полноценного поиска конкурентов по видимости их сайтов, как было рассказано в 4 пункте первого этапа данной статьи.
На странице конкурента, нужно обратить внимание на структуру категории, то есть существуют ли подкатегории, или посмотреть функционал фильтрации товаров. В нем уже присутствуют группы свойств, внутри которых мы можем увидеть маркеры

Копируем подкатегории и/или маркеры, которые нас интересуют, то есть то, что действительно есть у продвигаемого сайта в ассортименте, и выносим в наш файл:

Следующим шагом сцепляем все варианты написания нашего продукта с маркерами, чтобы получить различные запросы для последующего сбора семантического ядра уже по ним. Рекомендуем использовать функцию «СЦЕПИТЬ» в Microsoft Excel. В результате получим таблицу, аналогичную представленной ниже:

Для пакетной (разовой) загрузки всех ключевых слов в KeyCollector следует опять воспользоваться функцией «СЦЕПИТЬ» (формируем запросы в формате «Группа:Ключ»). Таким образом мы сможем разом добавить все запросы в единое поле программы, которая в свою очередь создаст необходимые группы и добавит в них соответствующие запросы для расширения ядра. Итоговый список запросов в необходимом формате: