Sql ключевое слово asc
Содержание:
- SQL Server функции строк
- SQL LIKE
- Пример — сортировка результатов по возрастанию
- SQL JOIN
- Почему не GROUP BY и не JOIN
- SQL Учебник
- Пример — использование ключевого слова LIMIT
- SQL Справочник
- SQL Пример ALTER TABLE
- Виды функций
- SQL Учебник
- SQL Подстановочные знаки
- Преимущества и недостатки
- SQL References
- Синтаксис
- SQL Учебник
SQL Server функции строк
| Функция | Описание |
|---|---|
| ASCII | Возвращает значение ASCII для конкретного символа |
| CHAR | Возвращает символ, основанный на коде ASCII |
| CHARINDEX | Возвращает положение подстроки в строке |
| CONCAT | Добавляет две или более строк вместе |
| Concat with + | Добавляет две или более строк вместе |
| CONCAT_WS | Добавляет две или более строк вместе с разделителем |
| DATALENGTH | Возвращает количество байтов, используемых для представления выражения |
| DIFFERENCE | Сравнивает два значения SOUNDEX и возвращает целое значение |
| FORMAT | Форматирует значение с указанным форматом |
| LEFT | Извлекает ряд символов из строки (начиная слева) |
| LEN | Возвращает длину строки |
| LOWER | Преобразует строку в нижний регистр |
| LTRIM | Удаляет начальные пробелы из строки |
| NCHAR | Возвращает символ Unicode, основанный на числовом коде |
| PATINDEX | Возвращает положение шаблона в строке |
| QUOTENAME | Возвращает строку Unicode с добавленными разделителями, чтобы сделать строку допустимым идентификатором с разделителями SQL Server |
| REPLACE | Заменяет все вхождения подстроки в строке на новую подстроку |
| REPLICATE | Повторяет строку заданное количество раз |
| REVERSE | Переворачивает строку и возвращает результат |
| RIGHT | Извлекает ряд символов из строки (начиная справа) |
| RTRIM | Удаляет конечные пробелы из строки |
| SOUNDEX | Возвращает четырехсимвольный код для оценки сходства двух строк |
| SPACE | Возвращает строку с указанным количеством пробелов |
| STR | Возвращает число в виде строки |
| STUFF | Удаляет часть строки, а затем вставляет другую часть в строку, начиная с указанной позиции |
| SUBSTRING | Извлекает некоторые символы из строки |
| TRANSLATE | Возвращает строку из первого аргумента после того, как символы, указанные во втором аргументе, будут переведены в символы, указанные в третьем аргументе. |
| TRIM | Удаляет начальные и конечные пробелы (или другие указанные символы) из строки |
| UNICODE | Возвращает значение Unicode для первого символа входного выражения |
| UPPER | Преобразует строку в верхний регистр |
SQL LIKE
Оператор LIKE используется в предложении WHERE для поиска указанного шаблона в столбце.
Есть два подстановочных знака, часто используемых в сочетании с оператором LIKE:
- % — Знак процента представляет собой ноль, один или несколько символов
- _ — Подчеркивание представляет собой один символ
Примечание: MS Access использует звездочку (*) вместо знака процента (%) и вопросительный знак (?) вместо подчеркивания (_).
Знак процента и подчеркивание также могут использоваться в комбинациях!
Синтаксис LIKE
SELECT column1, column2, …
FROM table_name
WHERE columnN LIKE pattern;
Совет: Вы также можете комбинировать любое количество условий с помощью операторов AND или OR.
Вот несколько примеров, показывающих различные операторы LIKE с подстановочными знаками ‘%’ и ‘_’:
| Оператор LIKE | Описание |
|---|---|
| WHERE CustomerName LIKE ‘a%’ | Находит любые значения, которые начинаются с «a» |
| WHERE CustomerName LIKE ‘%a’ | Находит любые значения, которые заканчиваются на «a» |
| WHERE CustomerName LIKE ‘%or%’ | Находит любые значения, которые имеют «or» в любой позиции |
| WHERE CustomerName LIKE ‘_r%’ | Находит любые значения, имеющие букву «r» во второй позиции |
| WHERE CustomerName LIKE ‘a__%’ | Находит любые значения, начинающиеся с буквы «a» и имеющие длину не менее 3 символов |
| WHERE ContactName LIKE ‘a%o’ | Находит любые значения, которые начинаются с «a» и заканчиваются «о» |
Пример — сортировка результатов по возрастанию
Чтобы отсортировать результаты в порядке возрастания, вы можете указать атрибут ASC. Если после поля в предложении ORDER BY не указано значение (ASC или DESC), порядок сортировки по умолчанию будет соответствовать возрастающему. Давайте рассмотрим это дальше. В этом примере у нас есть таблица customers со следующими данными:
| customer_id | first_name | last_name | favorite_website |
|---|---|---|---|
| 4000 | Justin | Bieber | google.com |
| 5000 | Selena | Gomez | bing.com |
| 6000 | Mila | Kunis | yahoo.com |
| 7000 | Tom | Cruise | oracle.com |
| 8000 | Johnny | Depp | NULL |
| 9000 | Russell | Crowe | google.com |
Введите следующий SQL оператор.
PgSQL
SELECT *
FROM customers
ORDER BY last_name;
|
1 2 3 |
SELECT* FROMcustomers ORDERBYlast_name; |
Будет выбрано 6 записей. Вот результаты, которые вы должны получить.
| customer_id | first_name | last_name | favorite_website |
|---|---|---|---|
| 4000 | Justin | Bieber | google.com |
| 9000 | Russell | Crowe | google.com |
| 7000 | Tom | Cruise | oracle.com |
| 8000 | Johnny | Depp | NULL |
| 5000 | Selena | Gomez | bing.com |
| 6000 | Mila | Kunis | yahoo.com |
В этом примере будут возвращены все записи из таблицы customers, отсортированные по полю last_name в порядке возрастания, и будет эквивалентен следующему SQL предложению ORDER BY.
PgSQL
SELECT *
FROM customers
ORDER BY last_name ASC;
|
1 2 3 |
SELECT* FROMcustomers ORDERBYlast_nameASC; |
Большинство программистов пропускают атрибут ASC при сортировке в порядке возрастания.
SQL JOIN
Предложение JOIN используется для объединения строк из двух или более таблиц на основе связанного столбца между ними.
Давайте рассмотрим выборку из таблицы «Orders»:
| OrderID | CustomerID | OrderDate |
|---|---|---|
| 10308 | 2 | 1996-09-18 |
| 10309 | 37 | 1996-09-19 |
| 10310 | 77 | 1996-09-20 |
Затем посмотрите на выборку из таблицы «Customers»:
| CustomerID | CustomerName | ContactName | Country |
|---|---|---|---|
| 1 | Alfreds Futterkiste | Maria Anders | Germany |
| 2 | Ana Trujillo Emparedados y helados | Ana Trujillo | Mexico |
| 3 | Antonio Moreno Taquería | Antonio Moreno | Mexico |
Обратите внимание, что столбец «CustomerID» в таблице «Orders» ссылается на «CustomerID» в таблице «Customers».
Связь между двумя приведенными выше таблицами представляет собой столбец «CustomerID». Затем мы можем создать следующий заявление SQL (содержащий внутреннее соединение),
который выбирает записи, имеющие совпадающие значения в обеих таблицах:
Затем мы можем создать следующий заявление SQL (содержащий внутреннее соединение),
который выбирает записи, имеющие совпадающие значения в обеих таблицах:
Пример
SELECT Orders.OrderID, Customers.CustomerName, Orders.OrderDate
FROM Orders
INNER JOIN Customers ON Orders.CustomerID=Customers.CustomerID;
и он будет производить что-то вроде этого:
| OrderID | CustomerName | OrderDate |
|---|---|---|
| 10308 | Ana Trujillo Emparedados y helados | 9/18/1996 |
| 10365 | Antonio Moreno Taquería | 11/27/1996 |
| 10383 | Around the Horn | 12/16/1996 |
| 10355 | Around the Horn | 11/15/1996 |
| 10278 | Berglunds snabbköp | 8/12/1996 |
Почему не GROUP BY и не JOIN
Сразу проясним, что оконные функции — это не то же самое, что GROUP BY. Они не уменьшают количество строк, а возвращают столько же значений, сколько получили на вход. Во-вторых, в отличие от GROUP BY, OVER может обращаться к другим строкам. И в-третьих, они могут считать скользящие средние и кумулятивные суммы.
Окей, с GROUP BY разобрались. Но в SQL практически всегда можно пойти несколькими путями. К примеру, может возникнуть желание использовать подзапросы или JOIN. Конечно, JOIN по производительности предпочтительнее подзапросов, а производительность конструкций JOIN и OVER окажется одинаковой. Но OVER даёт больше свободы, чем жёсткий JOIN. Да и объём кода в итоге окажется гораздо меньше.
SQL Учебник
SQL ГлавнаяSQL ВведениеSQL СинтаксисSQL SELECTSQL SELECT DISTINCTSQL WHERESQL AND, OR, NOTSQL ORDER BYSQL INSERT INTOSQL Значение NullSQL Инструкция UPDATESQL Инструкция DELETESQL SELECT TOPSQL MIN() и MAX()SQL COUNT(), AVG() и …SQL Оператор LIKESQL ПодстановочныйSQL Оператор INSQL Оператор BETWEENSQL ПсевдонимыSQL JOINSQL JOIN ВнутриSQL JOIN СлеваSQL JOIN СправаSQL JOIN ПолноеSQL JOIN СамSQL Оператор UNIONSQL GROUP BYSQL HAVINGSQL Оператор ExistsSQL Операторы Any, AllSQL SELECT INTOSQL INSERT INTO SELECTSQL Инструкция CASESQL Функции NULLSQL ХранимаяSQL Комментарии
Пример — использование ключевого слова LIMIT
Давайте посмотрим, как использовать оператор SELECT с опцией LIMIT в SQL. Например.
PgSQL
SELECT contact_id,
last_name,
first_name
FROM contacts
WHERE website = ‘Google.com’
ORDER BY contact_id DESC
LIMIT 5;
|
1 2 3 4 5 6 7 |
SELECTcontact_id, last_name, first_name FROMcontacts WHEREwebsite=’Google.com’ ORDERBYcontact_idDESC LIMIT5; |
В этом SQL примере SELECT LIMIT будут выбраны первые 5 записей из таблицы contacts, где website — ‘Google.com’
Обратите внимание, что результаты сортируются по contact_id в порядке убывания, поэтому это означает, что 5 самых максимальных значений contact_id будут возвращены оператором SELECT LIMIT. Если в таблице contacts есть другие записи со значением website ‘Google.com’, они не будут возвращены оператором SELECT LIMIT в SQL
Если бы мы хотели выбрать 5 самых минимальных значений contact_id вместо самых максимальных, мы могли бы изменить порядок сортировки следующим образом.
PgSQL
SELECT contact_id,
last_name,
first_name
FROM contacts
WHERE website = ‘Google.com’
ORDER BY contact_id ASC
LIMIT 5;
|
1 2 3 4 5 6 7 |
SELECTcontact_id, last_name, first_name FROMcontacts WHEREwebsite=’Google.com’ ORDERBYcontact_idASC LIMIT5; |
Теперь результаты будут отсортированы по contact_id в порядке возрастания, поэтому первые 5 самых минимальных записей contact_id, которые имеют website — ‘Google.com’, будут возвращены этим запросом SELECT LIMIT. Никакие другие записи не будут возвращены этим запросом.
SQL Справочник
SQL Ключевые слова
ADD
ADD CONSTRAINT
ALTER
ALTER COLUMN
ALTER TABLE
ALL
AND
ANY
AS
ASC
BACKUP DATABASE
BETWEEN
CASE
CHECK
COLUMN
CONSTRAINT
CREATE
CREATE DATABASE
CREATE INDEX
CREATE OR REPLACE VIEW
CREATE TABLE
CREATE PROCEDURE
CREATE UNIQUE INDEX
CREATE VIEW
DATABASE
DEFAULT
DELETE
DESC
DISTINCT
DROP
DROP COLUMN
DROP CONSTRAINT
DROP DATABASE
DROP DEFAULT
DROP INDEX
DROP TABLE
DROP VIEW
EXEC
EXISTS
FOREIGN KEY
FROM
FULL OUTER JOIN
GROUP BY
HAVING
IN
INDEX
INNER JOIN
INSERT INTO
INSERT INTO SELECT
IS NULL
IS NOT NULL
JOIN
LEFT JOIN
LIKE
LIMIT
NOT
NOT NULL
OR
ORDER BY
OUTER JOIN
PRIMARY KEY
PROCEDURE
RIGHT JOIN
ROWNUM
SELECT
SELECT DISTINCT
SELECT INTO
SELECT TOP
SET
TABLE
TOP
TRUNCATE TABLE
UNION
UNION ALL
UNIQUE
UPDATE
VALUES
VIEW
WHERE
MySQL Функции
Функции строк
ASCII
CHAR_LENGTH
CHARACTER_LENGTH
CONCAT
CONCAT_WS
FIELD
FIND_IN_SET
FORMAT
INSERT
INSTR
LCASE
LEFT
LENGTH
LOCATE
LOWER
LPAD
LTRIM
MID
POSITION
REPEAT
REPLACE
REVERSE
RIGHT
RPAD
RTRIM
SPACE
STRCMP
SUBSTR
SUBSTRING
SUBSTRING_INDEX
TRIM
UCASE
UPPER
Функции чисел
ABS
ACOS
ASIN
ATAN
ATAN2
AVG
CEIL
CEILING
COS
COT
COUNT
DEGREES
DIV
EXP
FLOOR
GREATEST
LEAST
LN
LOG
LOG10
LOG2
MAX
MIN
MOD
PI
POW
POWER
RADIANS
RAND
ROUND
SIGN
SIN
SQRT
SUM
TAN
TRUNCATE
Функции дат
ADDDATE
ADDTIME
CURDATE
CURRENT_DATE
CURRENT_TIME
CURRENT_TIMESTAMP
CURTIME
DATE
DATEDIFF
DATE_ADD
DATE_FORMAT
DATE_SUB
DAY
DAYNAME
DAYOFMONTH
DAYOFWEEK
DAYOFYEAR
EXTRACT
FROM_DAYS
HOUR
LAST_DAY
LOCALTIME
LOCALTIMESTAMP
MAKEDATE
MAKETIME
MICROSECOND
MINUTE
MONTH
MONTHNAME
NOW
PERIOD_ADD
PERIOD_DIFF
QUARTER
SECOND
SEC_TO_TIME
STR_TO_DATE
SUBDATE
SUBTIME
SYSDATE
TIME
TIME_FORMAT
TIME_TO_SEC
TIMEDIFF
TIMESTAMP
TO_DAYS
WEEK
WEEKDAY
WEEKOFYEAR
YEAR
YEARWEEK
Функции расширений
BIN
BINARY
CASE
CAST
COALESCE
CONNECTION_ID
CONV
CONVERT
CURRENT_USER
DATABASE
IF
IFNULL
ISNULL
LAST_INSERT_ID
NULLIF
SESSION_USER
SYSTEM_USER
USER
VERSION
SQL Server функции
Функции строк
ASCII
CHAR
CHARINDEX
CONCAT
Concat with +
CONCAT_WS
DATALENGTH
DIFFERENCE
FORMAT
LEFT
LEN
LOWER
LTRIM
NCHAR
PATINDEX
QUOTENAME
REPLACE
REPLICATE
REVERSE
RIGHT
RTRIM
SOUNDEX
SPACE
STR
STUFF
SUBSTRING
TRANSLATE
TRIM
UNICODE
UPPER
Функции чисел
ABS
ACOS
ASIN
ATAN
ATN2
AVG
CEILING
COUNT
COS
COT
DEGREES
EXP
FLOOR
LOG
LOG10
MAX
MIN
PI
POWER
RADIANS
RAND
ROUND
SIGN
SIN
SQRT
SQUARE
SUM
TAN
Функции дат
CURRENT_TIMESTAMP
DATEADD
DATEDIFF
DATEFROMPARTS
DATENAME
DATEPART
DAY
GETDATE
GETUTCDATE
ISDATE
MONTH
SYSDATETIME
YEAR
Функции расширений
CAST
COALESCE
CONVERT
CURRENT_USER
IIF
ISNULL
ISNUMERIC
NULLIF
SESSION_USER
SESSIONPROPERTY
SYSTEM_USER
USER_NAME
MS Access функции
Функции строк
Asc
Chr
Concat with &
CurDir
Format
InStr
InstrRev
LCase
Left
Len
LTrim
Mid
Replace
Right
RTrim
Space
Split
Str
StrComp
StrConv
StrReverse
Trim
UCase
Функции чисел
Abs
Atn
Avg
Cos
Count
Exp
Fix
Format
Int
Max
Min
Randomize
Rnd
Round
Sgn
Sqr
Sum
Val
Функции дат
Date
DateAdd
DateDiff
DatePart
DateSerial
DateValue
Day
Format
Hour
Minute
Month
MonthName
Now
Second
Time
TimeSerial
TimeValue
Weekday
WeekdayName
Year
Другие функции
CurrentUser
Environ
IsDate
IsNull
IsNumeric
SQL ОператорыSQL Типы данныхSQL Краткий справочник
SQL Пример ALTER TABLE
Посмотрите на таблицу «Persons»:
| ID | LastName | FirstName | Address | City |
|---|---|---|---|---|
| 1 | Hansen | Ola | Timoteivn 10 | Sandnes |
| 2 | Svendson | Tove | Borgvn 23 | Sandnes |
| 3 | Pettersen | Kari | Storgt 20 | Stavanger |
Теперь мы хотим добавить столбец с именем «DateOfBirth» в таблицу «Persons».
Мы используем следующую инструкцию SQL:
ALTER TABLE Persons
ADD DateOfBirth date;
Обратите внимание, что новый столбец «DateOfBirth» имеет тип date и будет содержать дату.
Тип данных указывает, какой тип данных может содержать столбец.
Для получения полного описания всех типов данных, доступных в MS Access, MySQL и SQL Server,
перейдите к нашему полному Справочнику типов данных. Таблица «Persons» теперь будет выглядеть так:
Таблица «Persons» теперь будет выглядеть так:
| ID | LastName | FirstName | Address | City | DateOfBirth |
|---|---|---|---|---|---|
| 1 | Hansen | Ola | Timoteivn 10 | Sandnes | |
| 2 | Svendson | Tove | Borgvn 23 | Sandnes | |
| 3 | Pettersen | Kari | Storgt 20 | Stavanger |
Виды функций
Оконные функции можно подразделить на следующие группы:
- Агрегатные функции;
- Ранжирующие функции;
- Функции смещения;
- Аналитические функции.
В одной инструкции SELECT с одним предложением FROM можно использовать сразу несколько оконных функций. Давайте подробно разберем каждую группу и пройдемся по основным функциям.
Агрегатные функции
Агрегатные функции – это функции, которые выполняют на наборе данных арифметические вычисления и возвращают итоговое значение.
- SUM – возвращает сумму значений в столбце;
- COUNT — вычисляет количество значений в столбце (значения NULL не учитываются);
- AVG — определяет среднее значение в столбце;
- MAX — определяет максимальное значение в столбце;
- MIN — определяет минимальное значение в столбце.
Пример использования агрегатных функций с оконной инструкцией OVER:
SELECT
  Date
, Medium
, Conversions
, SUM(Conversions) OVER(PARTITION BY Date) AS 'Sum'
, COUNT(Conversions) OVER(PARTITION BY Date) AS 'Count'
, AVG(Conversions) OVER(PARTITION BY Date) AS 'Avg'
, MAX(Conversions) OVER(PARTITION BY Date) AS 'Max'
, MIN(Conversions) OVER(PARTITION BY Date) AS 'Min'
FROM Orders

Ранжирующие функции
Ранжирующие функции – это функции, которые ранжируют значение для каждой строки в окне. Например, их можно использовать для того, чтобы присвоить порядковый номер строке или составить рейтинг.
- ROW_NUMBER – функция возвращает номер строки и используется для нумерации;
- RANK — функция возвращает ранг каждой строки. В данном случае значения уже анализируются и, в случае нахождения одинаковых, возвращает одинаковый ранг с пропуском следующего значения;
- DENSE_RANK — функция возвращает ранг каждой строки. Но в отличие от функции RANK, она для одинаковых значений возвращает ранг, не пропуская следующий;
- NTILE – это функция, которая позволяет определить к какой группе относится текущая строка. Количество групп задается в скобках.
SELECT
  Date
, Medium
, Conversions
, ROW_NUMBER() OVER(PARTITION BY Date ORDER BY Conversions) AS 'Row_number'
, RANK() OVER(PARTITION BY Date ORDER BY Conversions) AS 'Rank'
, DENSE_RANK() OVER(PARTITION BY Date ORDER BY Conversions) AS 'Dense_Rank'
, NTILE(3) OVER(PARTITION BY Date ORDER BY Conversions) AS 'Ntile'
FROM Orders

Функции смещения
Функции смещения – это функции, которые позволяют перемещаться и обращаться к разным строкам в окне, относительно текущей строки, а также обращаться к значениям в начале или в конце окна.
- LAG или LEAD – функция LAG обращается к данным из предыдущей строки окна, а LEAD к данным из следующей строки. Функцию можно использовать для того, чтобы сравнивать текущее значение строки с предыдущим или следующим. Имеет три параметра: столбец, значение которого необходимо вернуть, количество строк для смещения (по умолчанию 1), значение, которое необходимо вернуть если после смещения возвращается значение NULL;
- FIRST_VALUE или LAST_VALUE — с помощью функции можно получить первое и последнее значение в окне. В качестве параметра принимает столбец, значение которого необходимо вернуть.
SELECT
  Date
, Medium
, Conversions
, LAG(Conversions) OVER(PARTITION BY Date ORDER BY Date) AS 'Lag'
, LEAD(Conversions) OVER(PARTITION BY Date ORDER BY Date) AS 'Lead'
, FIRST_VALUE(Conversions) OVER(PARTITION BY Date ORDER BY Date) AS 'First_Value'
, LAST_VALUE(Conversions) OVER(PARTITION BY Date ORDER BY Date) AS 'Last_Value'
FROM Orders

Аналитические функции
Аналитические функции — это функции которые возвращают информацию о распределении данных и используются для статистического анализа.
- CUME_DIST — вычисляет интегральное распределение (относительное положение) значений в окне;
- PERCENT_RANK — вычисляет относительный ранг строки в окне;
- PERCENTILE_DISC — вычисляет определенный процентиль для отсортированных значений в наборе данных. В качестве параметра принимает процентиль, который необходимо вычислить.
Важно! У функций PERCENTILE_CONT и PERCENTILE_DISC, столбец, по которому будет происходить сортировка, указывается с помощью ключевого слова WITHIN GROUP
SELECT
  Date
, Medium
, Conversions
, CUME_DIST() OVER(PARTITION BY Date ORDER BY Conversions) AS 'Cume_Dist'
, PERCENT_RANK() OVER(PARTITION BY Date ORDER BY Conversions) AS 'Percent_Rank'
, PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY Conversions) OVER(PARTITION BY Date) AS 'Percentile_Cont'
, PERCENTILE_DISC(0.5) WITHIN GROUP (ORDER BY Conversions) OVER(PARTITION BY Date) AS 'Percentile_Disc'
FROM Orders

SQL Учебник
SQL ГлавнаяSQL ВведениеSQL СинтаксисSQL SELECTSQL SELECT DISTINCTSQL WHERESQL AND, OR, NOTSQL ORDER BYSQL INSERT INTOSQL Значение NullSQL Инструкция UPDATESQL Инструкция DELETESQL SELECT TOPSQL MIN() и MAX()SQL COUNT(), AVG() и …SQL Оператор LIKESQL ПодстановочныйSQL Оператор INSQL Оператор BETWEENSQL ПсевдонимыSQL JOINSQL JOIN ВнутриSQL JOIN СлеваSQL JOIN СправаSQL JOIN ПолноеSQL JOIN СамSQL Оператор UNIONSQL GROUP BYSQL HAVINGSQL Оператор ExistsSQL Операторы Any, AllSQL SELECT INTOSQL INSERT INTO SELECTSQL Инструкция CASESQL Функции NULLSQL ХранимаяSQL Комментарии
SQL Подстановочные знаки
Подстановочный знак используется для замены одного или нескольких символов в строке.
Подстановочные знаки используются с оператором SQL LIKE.
Оператор LIKE используется в предложении WHERE для поиска указанного шаблона в столбце.
Подстановочные знаки в MS Access
| Символ | Описание | Пример |
|---|---|---|
| * | Представляет ноль или более символов | bl* finds bl, black, blue, and blob |
| ? | Представляет собой один символ | h?t finds hot, hat, and hit |
| [] | Представляет любой отдельный символ в квадратных скобках | ht finds hot and hat, but not hit |
| ! | Представляет собой любой символ, не заключенный в скобки | ht finds hit, but not hot and hat |
| — | Представляет собой набор символов | ct finds cat and cbt |
| # | Представляет собой любой отдельный числовой символ | 2#5 finds 205, 215, 225, 235, 245, 255, 265, 275, 285, and 295 |
Подстановочные знаки в SQL Server
| Символ | Описание | Пример |
|---|---|---|
| % | Представляет ноль или более символов | bl% finds bl, black, blue, and blob |
| _ | Представляет собой один символ | h_t finds hot, hat, and hit |
| [] | Представляет любой отдельный символ в квадратных скобках | ht finds hot and hat, but not hit |
| ^ | Представляет собой любой символ, не заключенный в скобки | ht finds hit, but not hot and hat |
| — | Представляет собой набор символов | ct finds cat and cbt |
Все подстановочные знаки также могут быть использованы в комбинациях!
Вот несколько примеров, показывающих различные операторы LIKE с подстановочными знаками ‘%’ и ‘_’:
| Оператор LIKE | Описание |
|---|---|
| WHERE CustomerName LIKE ‘a%’ | Находит любые значения, которые начинаются с «a» |
| WHERE CustomerName LIKE ‘%a’ | Находит любые значения, которые заканчиваются на «a» |
| WHERE CustomerName LIKE ‘%or%’ | Находит любые значения, которые имеют «or» в любой позиции |
| WHERE CustomerName LIKE ‘_r%’ | Находит любые значения, имеющие букву «r» во второй позиции |
| WHERE CustomerName LIKE ‘a_%_%’ | Находит любые значения, начинающиеся с буквы «a» и имеющие длину не менее 3 символов |
| WHERE ContactName LIKE ‘a%o’ | Находит любые значения, которые начинаются с «a» и заканчиваются на «o» |
Преимущества и недостатки
Преимущества
- Независимость от конкретной СУБД
Несмотря на наличие диалектов и различий в синтаксисе, в большинстве своём тексты SQL-запросов, содержащие DDL и DML, могут быть достаточно легко перенесены из одной СУБД в другую. Существуют системы, разработчики которых изначально ориентировались на применение по меньшей мере нескольких СУБД (например: система электронного документооборота Documentum может работать как с Oracle Database, так и с Microsoft SQL Server и DB2). Естественно, что при применении некоторых специфичных для реализации возможностей такой переносимости добиться уже очень трудно.
- Наличие стандартов
Наличие стандартов и набора тестов для выявления совместимости и соответствия конкретной реализации SQL общепринятому стандарту только способствует «стабилизации» языка
Правда, стоит обратить внимание, что сам по себе стандарт местами чересчур формализован и раздут в размерах (например, базовая часть стандарта SQL:2003 состоит из более чем 1300 страниц текста).
- Декларативность
С помощью SQL программист описывает только то, какие данные нужно извлечь или модифицировать. То, каким образом это сделать, решает СУБД непосредственно при обработке SQL-запроса. Однако не стоит думать, что это полностью универсальный принцип — программист описывает набор данных для выборки или модификации, однако ему при этом полезно представлять, как СУБД будет разбирать текст его запроса. Чем сложнее сконструирован запрос, тем больше он допускает вариантов написания, различных по скорости выполнения, но одинаковых по итоговому набору данных.
Недостатки
- Несоответствие реляционной модели данных
Создатели реляционной модели данных Эдгар Кодд, Кристофер Дейт и их сторонники указывают на то, что SQL не является истинно реляционным языком. В частности, они указывают на следующие дефекты SQL с точки зрения реляционной теории:
- SQL разрешает в таблицах строки-дубликаты, что в рамках реляционной модели данных невозможно и недопустимо;
- SQL поддерживает неопределённые значения (NULL) и многозначную логику;
- SQL использует порядок колонок и ссылки на колонки по номерам;
- SQL разрешает колонки без имени и дублирующиеся имена колонок.
В опубликованном Кристофером Дейтом и Хью Дарвеном Третьем манифесте они излагают принципы СУБД следующего поколения и предлагают язык Tutorial D, который является подлинно реляционным.
- Сложность
Хотя SQL и задумывался как средство работы конечного пользователя, в конце концов он стал настолько сложным, что превратился в инструмент программиста.
- Отступления от стандартов
Несмотря на наличие международного стандарта ANSI SQL-92, многие разработчики СУБД вносят изменения в язык SQL, применяемый в разрабатываемой СУБД, тем самым отступая от стандарта. Таким образом появляются специфичные для каждой конкретной СУБД диалекты языка SQL.
- Сложность работы с иерархическими структурами
Ранее диалекты SQL большинства СУБД не предлагали способа манипуляции древовидными структурами. Некоторые поставщики СУБД предлагали свои решения (например, в Oracle Database используется выражение CONNECT BY). В настоящее время в ANSI стандартизована рекурсивная конструкция WITH из диалекта SQL DB2. В Microsoft SQL Server рекурсивные запросы (Recursive Common Table Expressions) появились лишь в версии 2005.
SQL References
SQL Keywords
ADD
ADD CONSTRAINT
ALTER
ALTER COLUMN
ALTER TABLE
ALL
AND
ANY
AS
ASC
BACKUP DATABASE
BETWEEN
CASE
CHECK
COLUMN
CONSTRAINT
CREATE
CREATE DATABASE
CREATE INDEX
CREATE OR REPLACE VIEW
CREATE TABLE
CREATE PROCEDURE
CREATE UNIQUE INDEX
CREATE VIEW
DATABASE
DEFAULT
DELETE
DESC
DISTINCT
DROP
DROP COLUMN
DROP CONSTRAINT
DROP DATABASE
DROP DEFAULT
DROP INDEX
DROP TABLE
DROP VIEW
EXEC
EXISTS
FOREIGN KEY
FROM
FULL OUTER JOIN
GROUP BY
HAVING
IN
INDEX
INNER JOIN
INSERT INTO
INSERT INTO SELECT
IS NULL
IS NOT NULL
JOIN
LEFT JOIN
LIKE
LIMIT
NOT
NOT NULL
OR
ORDER BY
OUTER JOIN
PRIMARY KEY
PROCEDURE
RIGHT JOIN
ROWNUM
SELECT
SELECT DISTINCT
SELECT INTO
SELECT TOP
SET
TABLE
TOP
TRUNCATE TABLE
UNION
UNION ALL
UNIQUE
UPDATE
VALUES
VIEW
WHERE
MySQL Functions
String Functions
ASCII
CHAR_LENGTH
CHARACTER_LENGTH
CONCAT
CONCAT_WS
FIELD
FIND_IN_SET
FORMAT
INSERT
INSTR
LCASE
LEFT
LENGTH
LOCATE
LOWER
LPAD
LTRIM
MID
POSITION
REPEAT
REPLACE
REVERSE
RIGHT
RPAD
RTRIM
SPACE
STRCMP
SUBSTR
SUBSTRING
SUBSTRING_INDEX
TRIM
UCASE
UPPER
Numeric Functions
ABS
ACOS
ASIN
ATAN
ATAN2
AVG
CEIL
CEILING
COS
COT
COUNT
DEGREES
DIV
EXP
FLOOR
GREATEST
LEAST
LN
LOG
LOG10
LOG2
MAX
MIN
MOD
PI
POW
POWER
RADIANS
RAND
ROUND
SIGN
SIN
SQRT
SUM
TAN
TRUNCATE
Date Functions
ADDDATE
ADDTIME
CURDATE
CURRENT_DATE
CURRENT_TIME
CURRENT_TIMESTAMP
CURTIME
DATE
DATEDIFF
DATE_ADD
DATE_FORMAT
DATE_SUB
DAY
DAYNAME
DAYOFMONTH
DAYOFWEEK
DAYOFYEAR
EXTRACT
FROM_DAYS
HOUR
LAST_DAY
LOCALTIME
LOCALTIMESTAMP
MAKEDATE
MAKETIME
MICROSECOND
MINUTE
MONTH
MONTHNAME
NOW
PERIOD_ADD
PERIOD_DIFF
QUARTER
SECOND
SEC_TO_TIME
STR_TO_DATE
SUBDATE
SUBTIME
SYSDATE
TIME
TIME_FORMAT
TIME_TO_SEC
TIMEDIFF
TIMESTAMP
TO_DAYS
WEEK
WEEKDAY
WEEKOFYEAR
YEAR
YEARWEEK
Advanced Functions
BIN
BINARY
CASE
CAST
COALESCE
CONNECTION_ID
CONV
CONVERT
CURRENT_USER
DATABASE
IF
IFNULL
ISNULL
LAST_INSERT_ID
NULLIF
SESSION_USER
SYSTEM_USER
USER
VERSION
SQL Server Functions
String Functions
ASCII
CHAR
CHARINDEX
CONCAT
Concat with +
CONCAT_WS
DATALENGTH
DIFFERENCE
FORMAT
LEFT
LEN
LOWER
LTRIM
NCHAR
PATINDEX
QUOTENAME
REPLACE
REPLICATE
REVERSE
RIGHT
RTRIM
SOUNDEX
SPACE
STR
STUFF
SUBSTRING
TRANSLATE
TRIM
UNICODE
UPPER
Numeric Functions
ABS
ACOS
ASIN
ATAN
ATN2
AVG
CEILING
COUNT
COS
COT
DEGREES
EXP
FLOOR
LOG
LOG10
MAX
MIN
PI
POWER
RADIANS
RAND
ROUND
SIGN
SIN
SQRT
SQUARE
SUM
TAN
Date Functions
CURRENT_TIMESTAMP
DATEADD
DATEDIFF
DATEFROMPARTS
DATENAME
DATEPART
DAY
GETDATE
GETUTCDATE
ISDATE
MONTH
SYSDATETIME
YEAR
Advanced Functions
CAST
COALESCE
CONVERT
CURRENT_USER
IIF
ISNULL
ISNUMERIC
NULLIF
SESSION_USER
SESSIONPROPERTY
SYSTEM_USER
USER_NAME
MS Access Functions
String Functions
Asc
Chr
Concat with &
CurDir
Format
InStr
InstrRev
LCase
Left
Len
LTrim
Mid
Replace
Right
RTrim
Space
Split
Str
StrComp
StrConv
StrReverse
Trim
UCase
Numeric Functions
Abs
Atn
Avg
Cos
Count
Exp
Fix
Format
Int
Max
Min
Randomize
Rnd
Round
Sgn
Sqr
Sum
Val
Date Functions
Date
DateAdd
DateDiff
DatePart
DateSerial
DateValue
Day
Format
Hour
Minute
Month
MonthName
Now
Second
Time
TimeSerial
TimeValue
Weekday
WeekdayName
Year
Other Functions
CurrentUser
Environ
IsDate
IsNull
IsNumeric
SQL Quick Ref
Синтаксис
Окно определяется с помощью обязательной инструкции OVER(). Давайте рассмотрим синтаксис этой инструкции:
SELECT
Название функции (столбец для вычислений)
OVER (
      PARTITION BY столбец для группировки
      ORDER BY столбец для сортировки
      ROWS или RANGE выражение для ограничения строк в пределах группы
      )
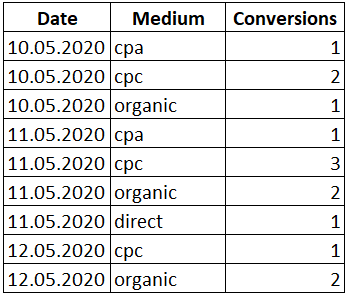
Теперь разберем как поведет себя множество строк при использовании того или иного ключевого слова функции. А тренироваться будем на простой табличке содержащей дату, канал с которого пришел пользователь и количество конверсий:
OVER()
Откроем окно при помощи OVER() и просуммируем столбец «Conversions»:
SELECT
  Date
, Medium
, Conversions
, SUM(Conversions) OVER() AS 'Sum'
FROM Orders

Мы использовали инструкцию OVER() без предложений. В таком варианте окном будет весь набор данных и никакая сортировка не применяется. Появился новый столбец «Sum» и для каждой строки выводится одно и то же значение 14. Это сквозная сумма всех значений колонки «Conversions».
PARTITION BY
Теперь применим инструкцию PARTITION BY, которая определяет столбец, по которому будет производиться группировка и является ключевой в разделении набора строк на окна:
SELECT
  Date
, Medium
, Conversions
, SUM(Conversions) OVER(PARTITION BY Date) AS 'Sum'
FROM Orders

Инструкция PARTITION BY сгруппировала строки по полю «Date». Теперь для каждой группы рассчитывается своя сумма значений столбца «Conversions».
ORDER BY
Попробуем отсортировать значения внутри окна при помощи ORDER BY:
SELECT
  Date
, Medium
, Conversions
, SUM(Conversions) OVER(PARTITION BY Date ORDER BY Medium) AS 'Sum'
FROM Orders

К предложению PARTITION BY добавилось ORDER BY по полю «Medium». Таким образом мы указали, что хотим видеть сумму не всех значений в окне, а для каждого значения «Conversions» сумму со всеми предыдущими. То есть мы посчитали нарастающий итог.
ROWS или RANGE
Инструкция ROWS позволяет ограничить строки в окне, указывая фиксированное количество строк, предшествующих или следующих за текущей.
Инструкция RANGE, в отличие от ROWS, работает не со строками, а с диапазоном строк в инструкции ORDER BY. То есть под одной строкой для RANGE могут пониматься несколько физических строк одинаковых по рангу.
Обе инструкции ROWS и RANGE всегда используются вместе с ORDER BY.
В выражении для ограничения строк ROWS или RANGE также можно использовать следующие ключевые слова:
- UNBOUNDED PRECEDING — указывает, что окно начинается с первой строки группы;
- UNBOUNDED FOLLOWING – с помощью данной инструкции можно указать, что окно заканчивается на последней строке группы;
- CURRENT ROW – инструкция указывает, что окно начинается или заканчивается на текущей строке;
- BETWEEN «граница окна» AND «граница окна» — указывает нижнюю и верхнюю границу окна;
- «Значение» PRECEDING – определяет число строк перед текущей строкой (не допускается в предложении RANGE).;
- «Значение» FOLLOWING — определяет число строк после текущей строки (не допускается в предложении RANGE).
Разберем на примере:
SELECT
  Date
, Medium
, Conversions
, SUM(Conversions) OVER(PARTITION BY Date ORDER BY Conversions ROWS BETWEEN CURRENT ROW AND 1 FOLLOWING) AS 'Sum'
FROM Orders

В данном случае сумма рассчитывается по текущей и следующей ячейке в окне. А последняя строка в окне имеет то же значение, что и столбец «Conversions», потому что больше не с чем складывать.
Комбинируя ключевые слова, вы можете подогнать диапазон работы оконной функции под вашу специфическую задачу.
SQL Учебник
SQL ГлавнаяSQL ВведениеSQL СинтаксисSQL SELECTSQL SELECT DISTINCTSQL WHERESQL AND, OR, NOTSQL ORDER BYSQL INSERT INTOSQL Значение NullSQL Инструкция UPDATESQL Инструкция DELETESQL SELECT TOPSQL MIN() и MAX()SQL COUNT(), AVG() и …SQL Оператор LIKESQL ПодстановочныйSQL Оператор INSQL Оператор BETWEENSQL ПсевдонимыSQL JOINSQL JOIN ВнутриSQL JOIN СлеваSQL JOIN СправаSQL JOIN ПолноеSQL JOIN СамSQL Оператор UNIONSQL GROUP BYSQL HAVINGSQL Оператор ExistsSQL Операторы Any, AllSQL SELECT INTOSQL INSERT INTO SELECTSQL Инструкция CASESQL Функции NULLSQL ХранимаяSQL Комментарии